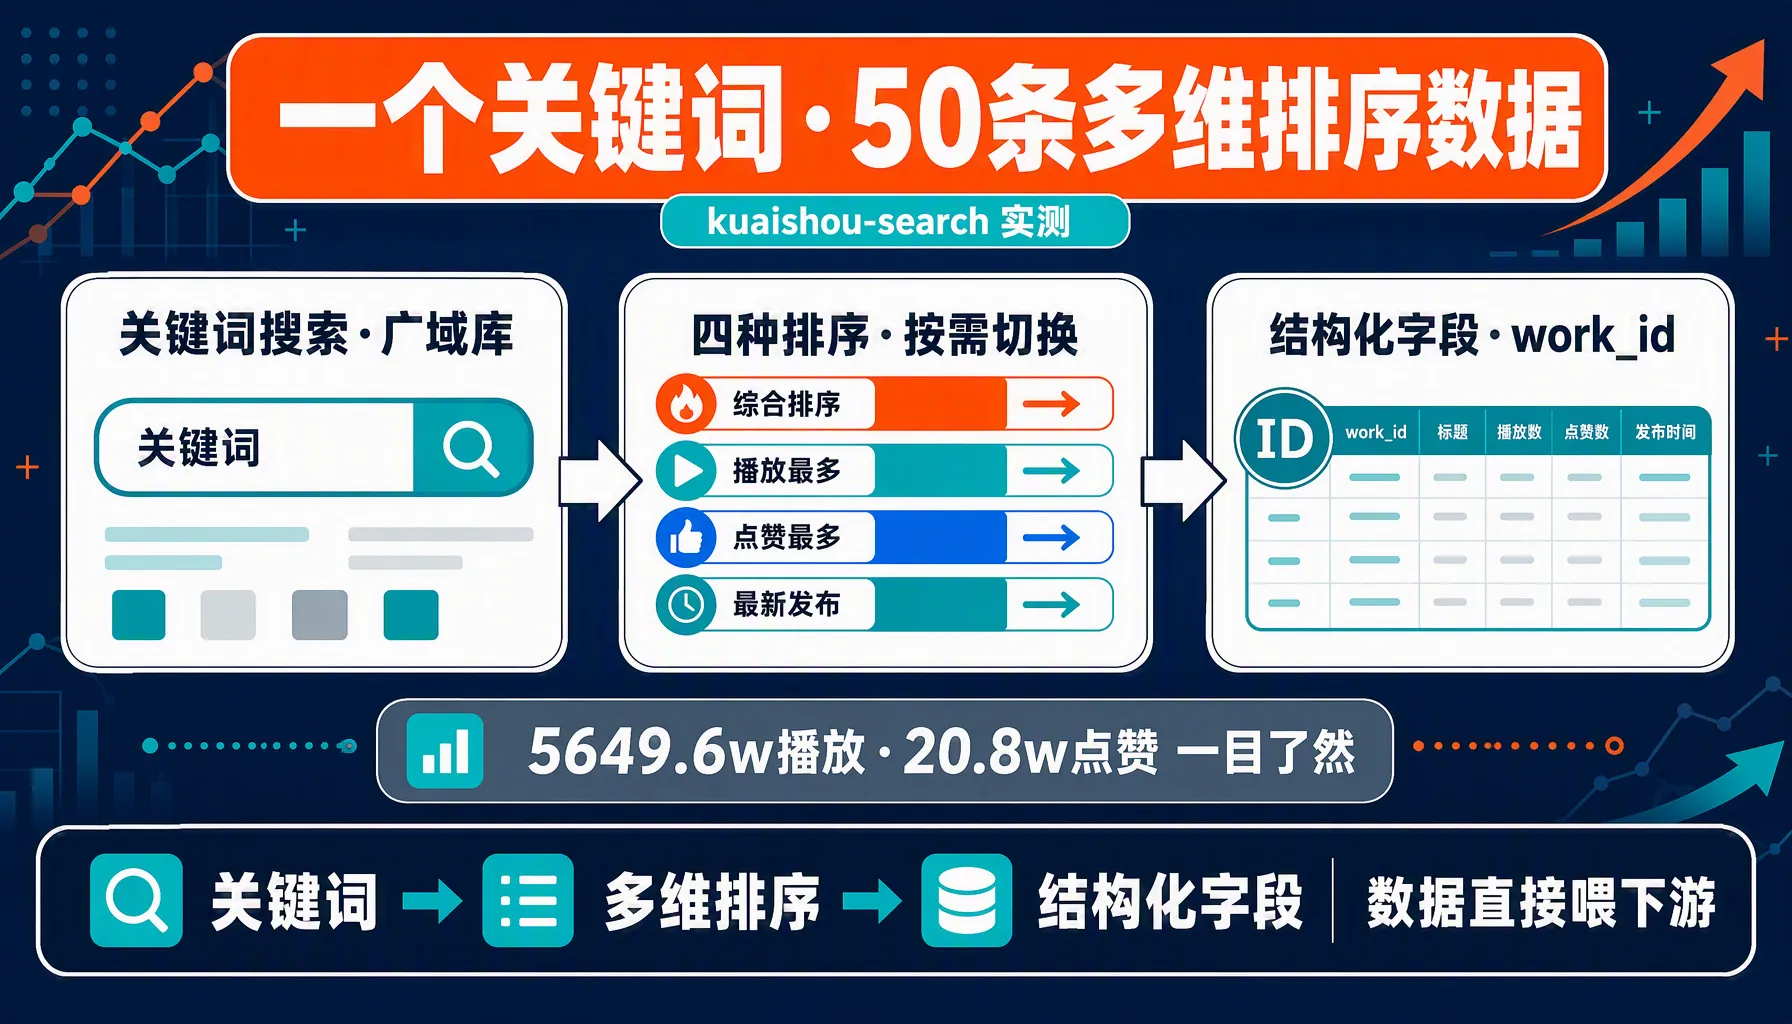
试试搜索 1 个关键词,返回 50 条结构化数据。本文对红狐 hub 的「快手作品搜索」Skill(kuaishou-search)进行系统测试,拆解 4 种排序方式的业务语义、广域库的数据边界,从互动数据中提炼 3 组可量化信号,记录 4 个工程踩坑案例,最后给出 3 条 Skill 全链路的组合方案。
01 背景:从人工刷选到数据驱动的选题调研
尝试用传统方式做选题调研:打开快手 App,在推荐流刷 1 小时。记得住的大概是"有几条很火",但具体火在哪、什么规律、热度量级差距有多大,都说不清楚。
传统的调研路径有 3 个结构性缺陷:
- 无法横向对比:推荐流中内容是单条呈现的,无法把多条爆款并排比较互动数据
- 无法按维度筛选:排序逻辑是黑盒,无法按播放量、点赞数、收藏数自定排序
- 缺少结构化输出:调研结果是印象而非记录,一周前的调研结论很难回溯
结构化搜索工具的价值不在于"搜得快",而在于把印象变成可量化的字段。
02 数据模型:搜索参数与结果字段
看搜索请求的核心参数,包含 5 个字段:
{
  "keyword": "美食",
  "sort": "like",
  "order": "desc",
  "page": 1,
  "page_size": 50,
  "source": "broad"
}
参数与返回字段的完整结构如下:
| 类别 | 名称 | 类型/可选值 | 说明 |
|---|---|---|---|
| 请求参数 | keyword | 任意文本 | 越具体越精准,如"东北铁锅炖教程" |
| 请求参数 | sort | comprehensive/time/like/favorite | 4 种排序维度 |
| 请求参数 | page | ≥1 | 翻页参数 |
| 请求参数 | page_size | 50 | 固定值 |
| 请求参数 | source | broad | 广域库热门内容 |
| 返回字段 | 标题 | string | 作品标题 |
| 返回字段 | 作者 | string | 作者昵称 |
| 返回字段 | 播放数 | string | ≥10000 时以 x.xw 缩写,如 5649.6w |
| 返回字段 | 点赞数 | string | 核心互动指标,如 20.8w |
| 返回字段 | 评论数 | int | 用户参与深度指标 |
| 返回字段 | 收藏数 | string | 实用型内容关键指标,如 1.9w |
| 返回字段 | 发布时间 | datetime | 精确到秒 |
| 返回字段 | work_id | string | 关联下游接口的标识 |
实际输出示例(官方数据):
# | 作品标题                          | 作者            | 播放数   | 点赞数 | 评论数 | 收藏数 | 发布时间
1 | 老铁们,我是罗纳尔多…             | Ronaldo罗纳尔多  | 5649.6w  | 20.8w  | 4329   | 1.9w   | 2026-06-12 18:18:42
2 | 第52集|〈越界之吻〉合集来啦…       | 茜二吨           | 2310.5w  | 33.2w  | 6236   | 5.9w   | 2026-06-19 18:35:46
03 四类排序的业务语义
看看 4 种排序方式分别对应的调研目标:
| 排序 | 使用场景 | 业务含义 |
|---|---|---|
| 综合排序 | 首次探索赛道 | 平台默认权重,兼顾热度与相关性 |
| 最新发布 | 实时动态监控 | 按发布时间降序,追踪正在起量的内容 |
| 最多点赞 | 爆款共性分析 | 历史累计最高互动,适合选题对标 |
| 最多收藏 | 实用型内容筛选 | 高收藏意味着"以后会用",适合教程/攻略类选题 |
注意一个常见误用:用"最多点赞"做趋势判断。按点赞排序看到的是历史累计结果,不代表当下热度。想看"正在起量"的内容,应该用"最新发布"排序配合发布时间字段判断增速。
04 交互方式与环境配置
使用自然语言驱动的搜索指令,输入 5 种常用查询之一即可触发:
# 基础搜索
"搜一下美食内容"

# 指定排序
"看看播放最多的世界杯作品"

# 切换排序
"按综合排序重新搜索"

# 翻页
"下一页"

# 关联下游提取
"查看第3条作品的视频详情"
环境变量配置与视频提文案 Skill 共用同一套鉴权体系:
$env:REDFOX_API_KEY = "your-api-key-here"注意数据展示格式:数值 ≥ 10000 时以 x.xw 格式展示(如 5649.6w)。导出到 Excel 做二次分析时需要还原为数字,避免字符串排序错误。
05 踩坑:搜索场景的四个工程陷阱
1. 广域库覆盖热门,但不覆盖全量。
"广域库"收录的是平台热门内容,长尾冷门内容可能不在索引范围内。搜索"美食"这种大词,返回的作品几乎全是头部大爆款。尝试把关键词缩窄——"东北铁锅炖教程"的有效性远大于"美食"。
2. w 单位缩写是阅读优化,不是数据分析格式。
计算 5649.6w ÷ 20.8w 得到点赞率 0.37%,这个计算的前提是先把 w 单位换算回数字。未换算的字符串排序会导致"9.8w"排到"200 万"后面的问题。记住在做数据分析前先完成单位还原。
3. 每页 50 条的数据密度,需要分批消化策略。
单页 50 条的全字段数据表对视觉扫描来说是高密度输出。建议分批策略:第一页只看头部 10 条,圈出 3-5 条值得深挖的,再翻页扩大样本量。翻页的目的是补充样本,不是逐条读完。
4. 排序选择直接决定调研结论的方向。
试试跑两次搜索——先用"最新"排序了解当前动态,再用"点赞"排序锁定历史爆款。两个视角叠加才能完整理解赛道内容格局。单次搜索的结论可能完全取决于排序方式。
06 数据解读方法论:三组可量化信号
记住一个原则:搜索结果中最有价值的不是单独某条数据的播放量,而是字段之间的关系。这 3 组关系可以直接用于选题判断:
信号一:点赞 / 播放比(Like-to-View Ratio)
点赞率 = 点赞数 ÷ 播放数
快手指南:头部爆款通常在 2%-5% 区间
检查两个阈值——低于 1% 说明内容被推荐流推了但留不住观众(标题党或开头缺乏钩子);高于 5% 说明内容质量明显高于同类,值得做结构拆解和选题方向分析。
信号二:收藏 vs 点赞比(Save-to-Like Ratio)
看看收藏数和点赞数的关系。收藏数接近甚至超过点赞数的内容,是典型的"实用型"内容——教程、清单、攻略。这类内容的粉丝价值高,适合作为账号的留存资产。
信号三:评论 / 点赞比(Comment-to-Like Ratio)
评论/点赞比 ≈ 评论数 ÷ 点赞数
超过 5% 的内容通常存在观点交锋或争议
记住高评论比的 2 个价值:评论区是选题金矿(需求类评论可转化为下一条内容),讨论度本身会驱动算法二次推荐。
07 适用场景与边界
| 场景 | 角色 | 收益 |
|---|---|---|
| 选题调研 | 内容创作者 | 快速锁定高互动方向 |
| 竞品监控 | 品牌运营 | 了解头部内容形态 |
| 趋势追踪 | 市场团队 | 按数据判断赛道热度 |
检查 3 个边界:搜索范围为快手平台,不覆盖其他短视频平台。适合选题调研、竞品监控、选品参考,不适合做单一账号的深度分析。跨平台数据对比需使用红狐生态中其他平台对应的搜索技能。
08 链路组合:从搜索到文案提取的数据管线
试试把搜索技能放入完整管线。搜索技能的标准用法是与其他快手 Skill 串行使用:
快手作品搜索(关键词 → 50 条榜单)
    ↓ 筛选出 high-potential 作品
快手视频提文案(work_id → 口播文案 + 时间戳)
    ↓ 拆解爆款结构
快手评论分析(作品链接 → 四维情感分析)
    ↓ 验证受众反应
这条管线的工程价值在于:3 条 Skill 共享同一套鉴权体系(REDFOX_API_KEY),数据字段在上下游之间天然一致,不存在格式转换和人工搬运的成本。
FAQ
Q1:数据是实时更新的吗?是否需要 API Key?每次查询实时调用红狐网关,无缓存,发布时间精确到秒。需配置 REDFOX_API_KEY。
Q2:需要编程基础吗?不需要。用自然语言描述关键词和排序方式即可触发对应查询。
Q3:按点赞排序搜到的就是最受欢迎的内容吗?是"历史累计最受欢迎",不代表当前热门趋势。趋势判断需结合"最新发布"排序和发布时间字段。