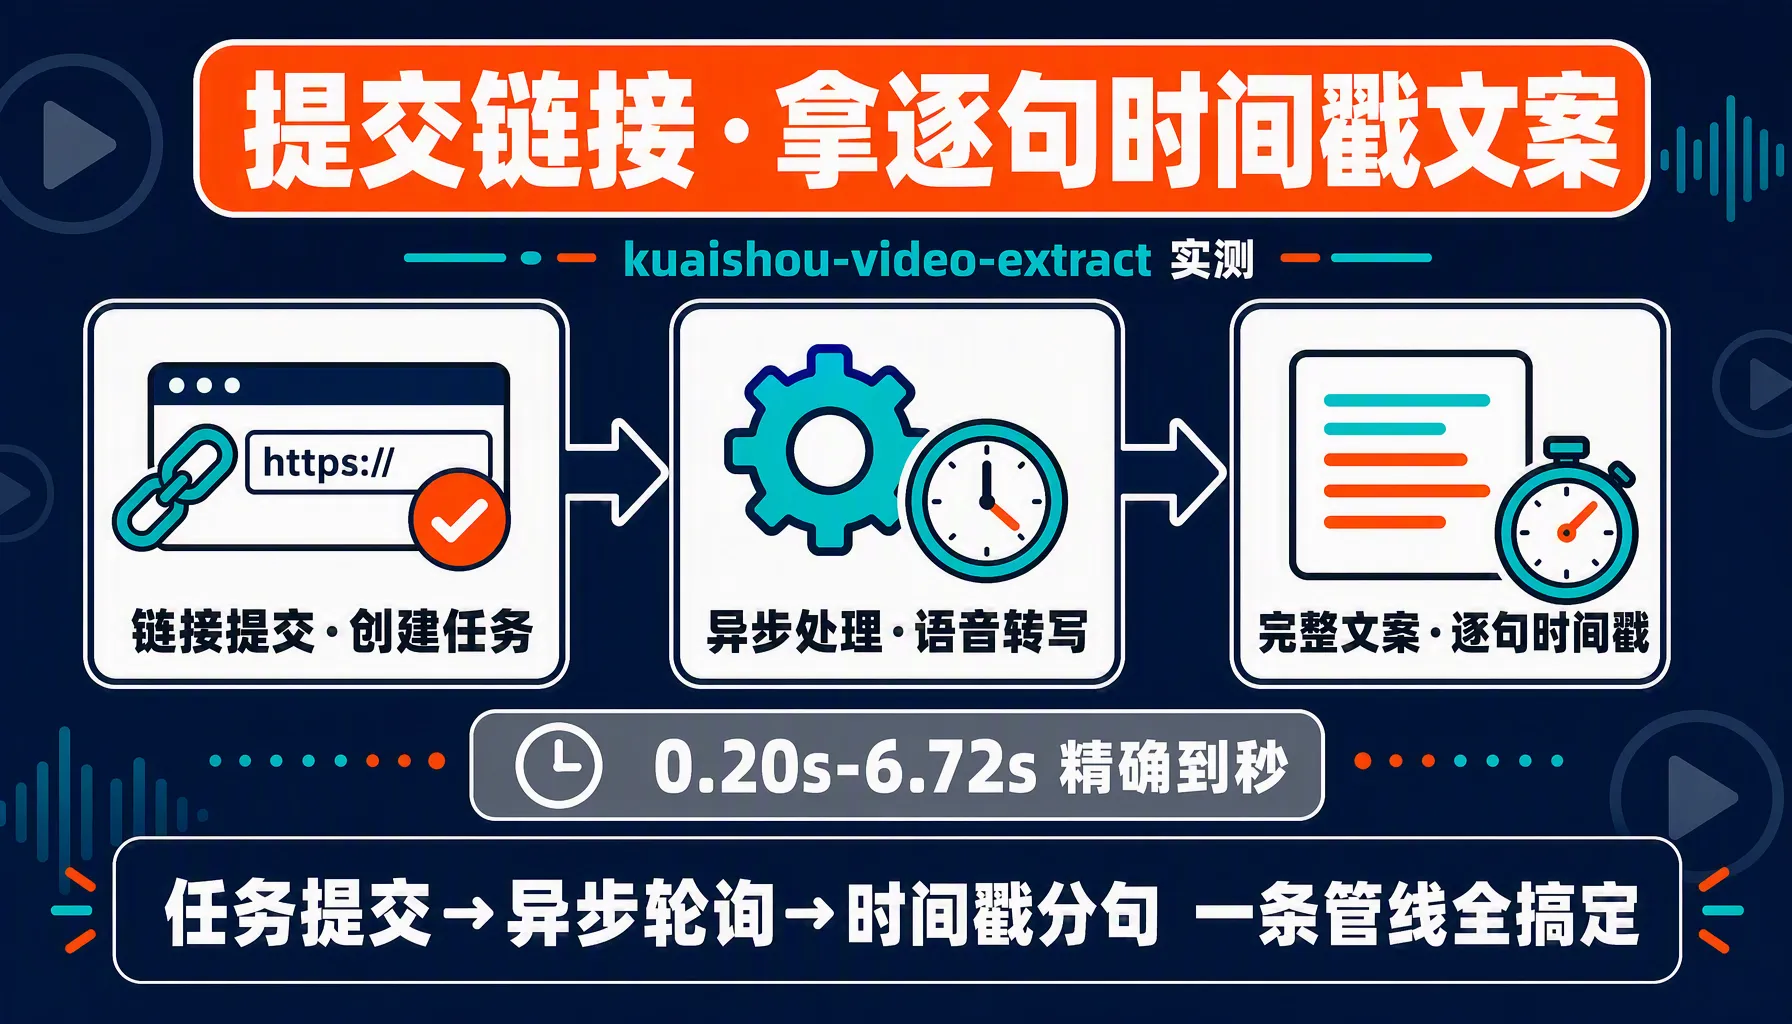
试试提取 1 条快手视频的口播文案有多快。本文完整测试红狐 hub 的「快手视频提文案」Skill,从任务提交到异步轮询再到逐句时间戳输出,拆解 3 个核心环节的工程实现,记录批量提取场景下的 3 个真实踩坑案例,最后给出 3 条 Skill 组合使用的工程管线。
01 背景:口播转录的效率瓶颈
尝试手动转录 1 条 3 分钟的快手口播视频:播放 → 暂停 → 打字 → 继续播放。按平均语速每分钟 200 字计算,完成转录需要 20-30 分钟,效率极低。
换成第三方语音识别工具,能解决"打字"这个体力环节,但引入新问题:背景音乐、音效、多人对话等干扰导致识别准确率下降 15-30%,额外的清洗时间又需要 10-15 分钟。
输入 1 条快手链接,等几十秒就能拿到带逐句时间戳的完整文案。这个 Skill 隐藏的工程细节比表面看起来复杂得多。
02 数据模型:任务系统与时间戳结构
从输出可以反推底层数据模型。提取请求的核心参数:
{
  "video_url": "https://www.kuaishou.com/short-video/3x4ibfzs5e68yxu",
  "task_mode": "async",
  "output_format": "text_with_timestamps"
}
执行流程是一个典型的异步任务模型,包含 4 个阶段:
用户提交链接
    ↓① 创建任务:生成唯一 task_id,返回给用户
任务进入 PENDING 状态
    ↓② 异步处理:后端下载视频 → 提取音频 → 语音转写 → 时间戳映射
    ↓③ 轮询结果:用户用 task_id 查询处理状态
任务完成 → 返回完整数据集返回的数据包含两大部分:完整文案 和 逐句时间戳。其中逐句时间戳的 4 个核心字段:
| 字段 | 含义 | 示例 |
|---|---|---|
| sequence | 句序 | 1 |
| start_time | 起始时间(秒) | 0.20 |
| end_time | 结束时间(秒) | 6.72 |
| text | 文案片段 | 视频中这个小孩今年才3岁,他叫苗苗… |
看一下这个模型的设计意图:输出的不是单一文本,而是时间-文本映射表。下游按需消费——做字幕取时间戳,拆脚本取完整文本,两者不冲突。
03 自然语言驱动的使用方式
使用自然语言交互,输入 6 种常用查询命令之一即可触发对应动作:
# 提取视频文案
"帮我提取这个快手视频的口播文案"

# 获取带时间戳的结果
"把这个视频的文案加上时间戳给我"

# 续查任务(超时/中断后)
"上次那个视频提取结果帮我查一下"

# 复刻脚本用途
"把这个爆款视频的文案提取出来,我要分析结构"
输出以结构化表格呈现:
📝 完整文案:

视频中这个小孩今年才3岁,他叫苗苗。锅里的青菜在油的包
裹下发出滋滋的声响……

📊 逐句时间戳:

# | 时间区间      | 文案片段
1 | 0.20s - 6.72s | 视频中这个小孩今年才3岁,他叫苗苗…
2 | 7.00s - 9.88s | 锅里的青菜在油的包裹下发出滋滋的声响。
04 环境配置与接入
打开 redfox.hk 注册账号,在控制台创建 API Key。配置到环境变量:
# 在 Windows PowerShell 中配置
$env:REDFOX_API_KEY = "your-api-key-here"

# 或在 IDE 的 .env 文件中持久化
REDFOX_API_KEY=your-api-key-here
鉴权通过 HTTP Header 传递:
GET /api/v1/skill/kuaishou-video-extract HTTP/1.1
Authorization: Bearer ${REDFOX_API_KEY}
注意 3 个安全约束:
- 禁止在代码、日志或输出文件中硬编码密钥
- 密钥由红狐 hub 统一签发,具有独立的作用域与有效期
- 定期轮换密钥是推荐的安全实践,控制台支持随时重置
05 踩坑:批量提取场景的三个教训
1. 任务超时的正确处理是续查,不是重提。
提取是异步任务,3 分钟以上的长视频可能超时。检查 task_id 的状态,不要重新提交。重复提交会创建新任务,浪费积分和时间。续查的输出与正常等待的输出完全一致,不存在信息损耗。
# 续查命令(自然语言)
"上次那个视频提取结果帮我查一下"
# 底层逻辑:ASSOCIATE task_id → POLL status → RETURN result
2. 转写输出是"原始稿",不是"精修稿"。
语音转写保留口语重复词、语气停顿和语法残缺。直接拿转写结果当最终文案,质量明显偏低。记住正确的使用流程:以转写结果为底稿,手工拆解结构和润色语言。工具的输出是分析原料,不是成品。
3. 时间戳精度到秒,但字幕断行需要后处理。
0.20s-6.72s 区间适合时间轴对应,但一句文案超过屏幕宽度时需要手动断行。工具交付的是时间-文本映射对,从映射到最终字幕还需要加一道排版工序。尝试对接外部字幕格式化工具做自动化处理,可以节省 40% 的后期时间。
06 工程思考:异步任务模型在内容工具中的应用
关注这个 Skill 的异步任务模型设计。同类工具有两种实现路径:
| 方案 | 延迟 | 可靠性 | 适合场景 |
|---|---|---|---|
| 同步阻塞 | 低(秒级) | 低,长视频易超时 | 短视频、低并发 |
| 异步轮询 | 高(秒到分钟级) | 高,支持续查 | 长视频、批量、不稳定网络 |
异步方案的取舍很清晰:
- 用户体验:接受"提交后等待"——3 分钟视频通常几十秒,大文件到分钟级
- 可靠性:天然支持轮询和续查,网络波动不丢任务,适合需要批量处理 20-50 条视频的运营场景
从实际操作看,异步的可靠性价值远大于等待时间成本——续查机制保证不会因为单条失败而需要重跑整批。
07 适用场景与边界
| 场景 | 角色 | 收益 |
|---|---|---|
| 爆款脚本复刻 | 内容创作者 | 获取口播稿,拆解选题结构与文案节奏 |
| 视频内容分析 | 运营/数据分析 | 快速转写,评估文案质量与信息密度 |
| 字幕制作 | 剪辑/字幕 | 用逐句时间戳生成字幕稿,精准匹配画面 |
检查 3 个边界——先看音频质量:背景噪音大、语速过快、方言口音等因素可能降低 10-20% 的转写准确率。再看视频长度:长视频提取耗时更长,受任务队列负载影响。最后注意版权:提取结果用于商业发布时注意原创风险,推荐作为分析样本而非发布底稿。
08 链路组合:与快手作品搜索 Skill 配合
试试把这条 Skill 放入内容运营管线。单独用这个 Skill 解决"已有链接的文案提取"问题。在完整工作流中,它与「快手作品搜索」Skill 存在上下游关系:
① 快手作品搜索(关键词 → 榜单)
    ↓ 发现爆款作品,获取 work_id
② 快手视频提文案(work_id → 文案 + 时间戳)
    ↓ 拆解爆款结构
③ 快手评论分析(作品链接 → 情感分析)
    ↓ 验证受众反馈
这条管线从"找爆款"到"拆结构"到"看反馈"三步串联,3 条 Skill 共享同一鉴权体系,字段在上下游之间天然一致——这是平台化工具相比独立工具的核心优势。
FAQ
Q1:提取是实时的吗?是否需要 API Key?每次提取实时调用红狐网关提交任务并轮询结果,无缓存。需在 redfox.hk 注册账号,创建 API Key 后配置到环境变量 REDFOX_API_KEY。
Q2:支持多长视频?超时如何处理?任务机制支持长视频,耗时与视频时长正相关。中途超时用 task_id 续查即可,不需要重新提交。
Q3:提取结果能否直接发布?用于拆解、学习、做字幕没问题;直接搬运发布涉及原创风险。推荐将其作为分析样本使用。