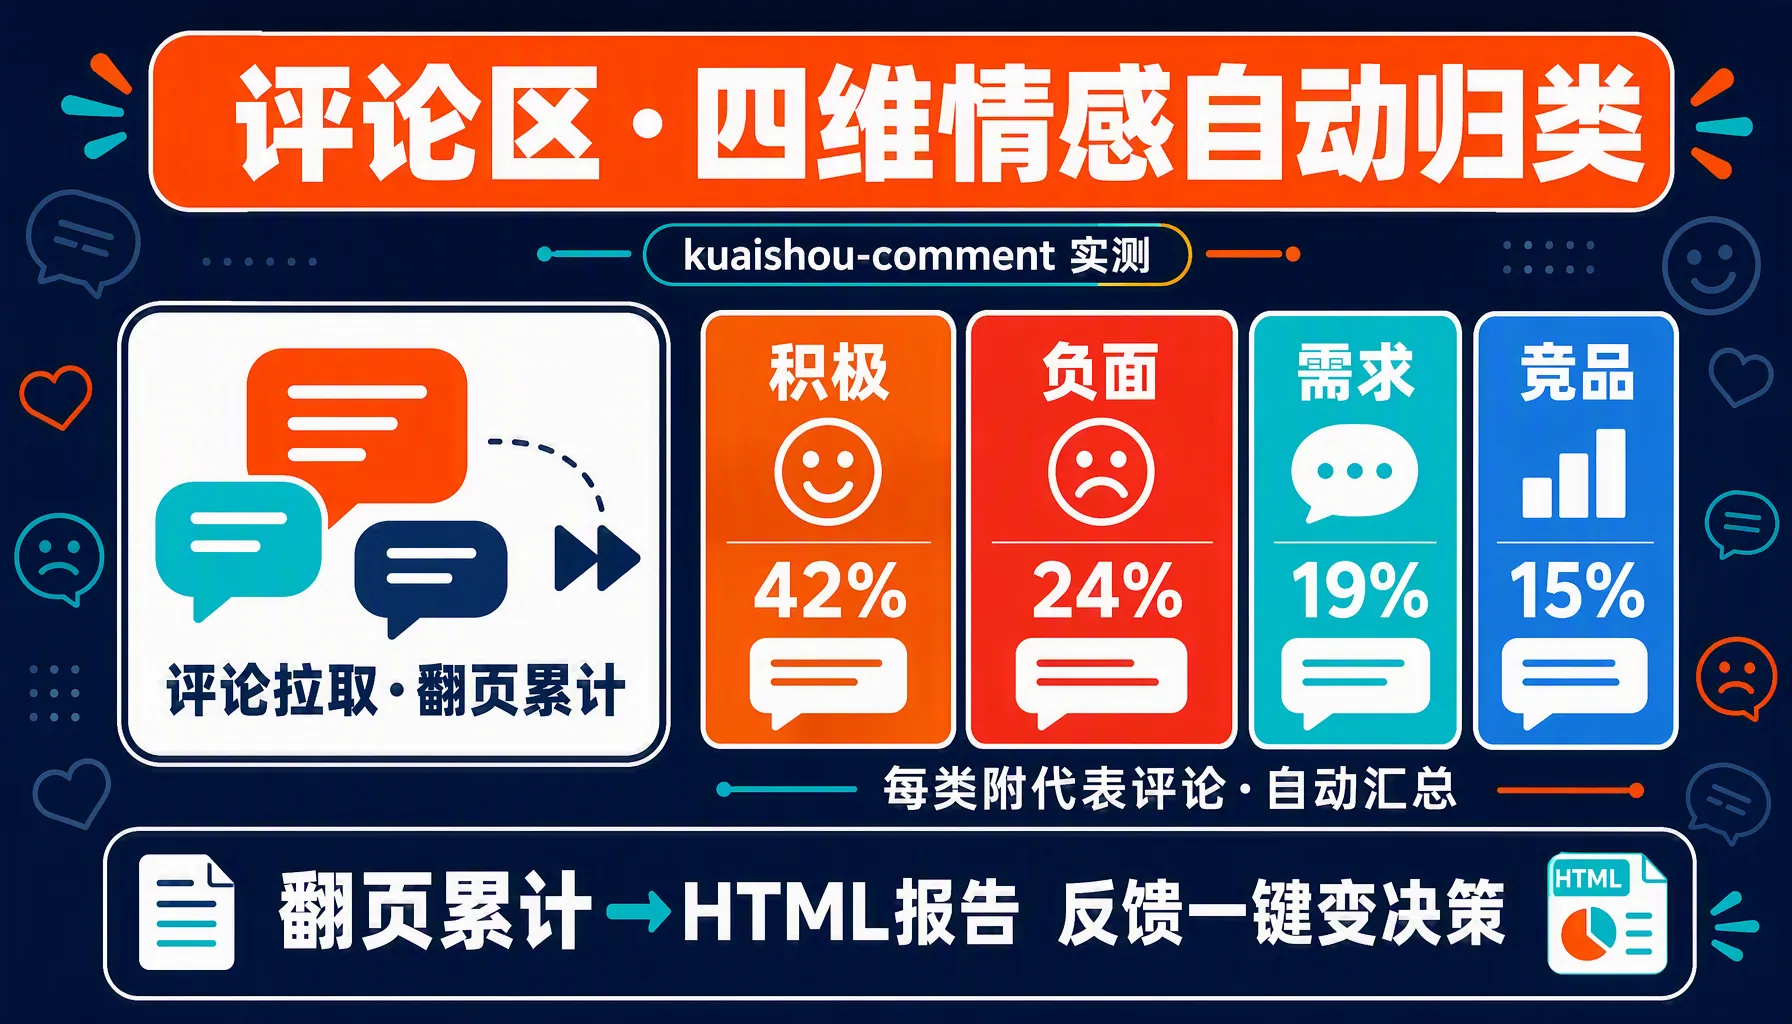
试试分析 1 条快手视频的评论区数据。本文对红狐 hub 的「快手评论分析」Skill(kuaishou-comment)进行系统测试,拆解从作品链接到四维情感分类再到 HTML 报告生成的技术管线,记录 4 个真实踩坑案例,最后给出 3 条 Skill 全链路的组合方案。
01 背景:评论区数据的结构化困境
翻 300 条快手评论需要多久?尝试手动操作:打开评论区 → 逐条翻看 → 记忆要点。20 分钟以上,翻完之后大脑已经被碎片化信息填满,很难形成结构化判断。
评论区数据的价值密度其实很高:
- 需求类评论直接告诉创作者下一期选题("求教程""求链接""求续集")
- 负面类评论是产品改进的免费清单
- 竞品类评论暴露了用户的交叉对比行为
问题是这 3 类信号淹没在大量碎片信息中,靠人工翻评论区很难系统化提取。
02 数据模型:从作品链接到结构化评论表
输入入口有 2 种方式:
{
  "input_type": "url",
  "value": "https://www.kuaishou.com/short-video/3x4ibfzs5e68yxu"
}
或直接输入作品 ID:
{
  "input_type": "opus_id",
  "value": "3x4ibfzs5e68yxu"
}
获取到的单条评论包含 7 个字段:
| 字段 | 含义 | 数据类型 |
|---|---|---|
| commenter | 评论人 | string |
| content | 评论内容 | string |
| likes | 点赞数 | int |
| replies | 回复数 | int |
| timestamp | 发布时间 | datetime |
| ip_location | IP 属地 | string(省级粒度) |
| is_pinned | 是否置顶 | boolean |
数据采集流程是一个游标翻页模型,包含 4 个阶段:
用户输入链接
    ↓① 首次请求:拉取第一页评论数据
返回完整评论表格 + 四维情感分析
    ↓② 用户回复"下一页"
    ↓③ 游标递增:累计分析已读所有页
    ↓④ 重复 ②-③ 直到用户结束
用户回复"生成 html" → 合并已浏览页面 → 输出 HTML 报告
03 四维情感分类的标签逻辑
核心算法不在"拉取评论",而在评论的情感分类——将非结构化的评论文本自动归入 4 类:
| 分类 | 标签含义 | 典型话术 | 运营动作 |
|---|---|---|---|
| 积极 | 正向反馈、认可内容 | "讲得好""学到了""太强了" | 验证内容方向正确 |
| 负面 | 批评、反对、不满 | "这也能火""讲得太浅" | 改进清单,下期解决问题 |
| 需求 | 表达真实需求 | "出个教程""求链接""下一期讲X" | 直接转化为选题 |
| 竞品 | 提到其他账号/产品 | "不如XX讲得好""去看XX" | 对标分析入口 |
看看每次查询的输出格式:
📈 AI 评论总结

积极占比:45% — 观众对内容方向高度认可,金句频出是核心驱动因素。
代表评论:「讲得好」「学到了」

负面占比:15% — 主要集中在前30秒节奏偏慢。
代表评论:「开头太拖了」「可以加速」

需求占比:30% — 大量求教程、求续集的评论。
代表评论:「求教程」「下一期讲XX」

竞品占比:10% — 少数提到竞品内容。
代表评论:「不如XX讲得细」
翻页时情感分析会自动累计——翻到第 3 页时,分析结论基于前 3 页所有评论。这个累计设计确保了评论越多、分析结论越稳定。
04 可视化报告的技术实现
生成报告时输出深色主题的交互式 HTML 文件,具备 4 个工程特性:
- 多页合并:已浏览的所有页面合并为一份报告,不用每页存一个文件
- 智能折叠:超过 3 页时自动折叠,防止单个 HTML 文件过长
- 离线保存:报告是自包含 HTML,不依赖外部 CDN 或服务器
- 可分享:适合放进选题会材料、周报文档
检查这个报告工程思路:把分析结论固化成可分发、可留存、可回溯的资产,而不是即用即走的控制台输出。
05 交互方式与环境配置
使用自然语言驱动,输入 4 种命令之一即可:
# 查看评论
"这个作品的评论怎么样" + 作品链接 → 评论表格 + 四维情感分析

# 直接指定作品 ID
"查看快手作品 3x4ibfzs5e68yxu 的评论" → 跳过链接提取

# 翻页
"下一页" → 继续拉取,累计分析

# 导出报告
"生成 html" → 已浏览页面合并为完整报告
环境变量配置与搜索、提取 Skill 共用同一套鉴权:
$env:REDFOX_API_KEY = "your-api-key-here"06 踩坑:评论区分析场景的四个教训
1. 正确顺序:先翻页,再出报告。
记住分析是累积的。翻到第 3 页时的分析结论基于前 3 页的数据,此时导出的报告才完整。只看第 1 页就导出,结论只覆盖第 1 页的评论,容易出现采样偏差。正确工作流:先翻完想看的评论范围,再触发报告生成。
2. 超 3 页智能折叠是优化特性,分享前需要手动展开确认。
报告折叠是为了防止单文件过长,但分享给同事前需要检查折叠部分是否包含关键信息。如果折叠页中有重要评论,应该展开后再分享。
3. IP 属地的定位精度是省级,不是精准定位。
IP 属地是快手平台提供的基础字段,粒度到省。它可以辅助分析评论的地域分布特征,但不能用于精准用户画像。对于评论分析来说,省级信息足以判断内容的地域穿透力——比如一、二线城市观众占比是否符合预期。
4. 四维分类的输出是"结构化摘要",不是"原始数据"。
情感分析将原始评论聚合成 4 类摘要,这是分析效率的体现,但分类器存在一定的准确率边界。对于关键决策(如竞品分析),建议回到原始评论验证 AI 分类结果。
07 四维分类的业务应用:从数据到决策
检查每一类评论对应的运营动作:
积极类 → 验证方向。检查积极占比是否稳定。关键指标不是单条视频的积极率,而是同一赛道上多条视频积极率的一致性——一致高说明赛道正确,忽高忽低说明选题风格还在试错。
负面类 → 改进清单。试试建立"负面关键词频率表",统计高频负面词,按出现频率排序后逐个解决。反复出现的负面评论是成本最低的用户反馈渠道。
需求类 → 选题储备。评论中直接表达的需求("求教程""出续集")是最确定的选题来源。把需求类评论收集到选题库中,可以作为 3-5 条内容的储备。这类评论的转化率远高于从榜单中猜测选题。
竞品类 → 对标入口。评论区出现竞品名称说明用户在做交叉对比。这是研究竞品内容策略的天然入口——可以顺藤摸瓜,用作品搜索技能查竞品的爆款内容,完成从评论到竞品拆解的完整动作。
08 适用场景与边界
| 场景 | 角色 | 收益 |
|---|---|---|
| 作品反馈分析 | 快手创作者 | 快速了解观众反应 |
| 舆情监控 | 品牌运营 | 掌握竞品或自身舆情 |
| 内容选题 | 内容策划 | 从评论区发掘用户需求 |
| 数据分析 | 数据分析师 | 量化评论数据 |
检查 3 个边界:评论内容覆盖快手平台,不跨平台。评论分析深度取决于评论数量本身——评论少的作品分析结论的代表性有限。IP 属地精确到省级,定位粒度不足以做精准地域营销。
09 三 Skill 全链路:从搜索到反馈的完整管线
试试把评论分析 Skill 放入全链路。单独使用时已经很有价值,但与其他快手 Skill 串行使用时,形成了一条从选题到反馈的完整管线:
快手作品搜索(关键词 → 榜单)
    ↓ 发现爆款作品
快手视频提文案(work_id → 文案 + 时间戳)
    ↓ 拆解内容结构
快手评论分析(作品链接 → 四维情感分析)
    ↓ 验证受众反应、发现选题方向
这条链路的工程价值在于:从"找内容"到"拆内容"到"验证内容"三步串联,3 条 Skill 不出一个鉴权体系,字段在上下游之间天然一致。对内容团队来说,选题从拍脑袋变成数据驱动,每一步的结论都有前一阶段的输出作为输入。
FAQ
Q1:能分析自己视频的评论吗?是否需要 API Key?可以,粘贴自己作品的链接即可。需在 redfox.hk 注册账号,创建 API Key 后配置到环境变量 REDFOX_API_KEY。
Q2:生成的可视化报告能分享吗?能。HTML 报告可离线保存,自包含格式不依赖外部服务,适合放入周报和选题会材料。
Q3:评论是一次性拉取完的吗?按页拉取,翻页时累计分析。建议先翻完想看的评论范围,再"生成 html"获取完整报告。