X 平台关键词搜索 Skill 实测:五种搜索模式与结构化结果的设计思路
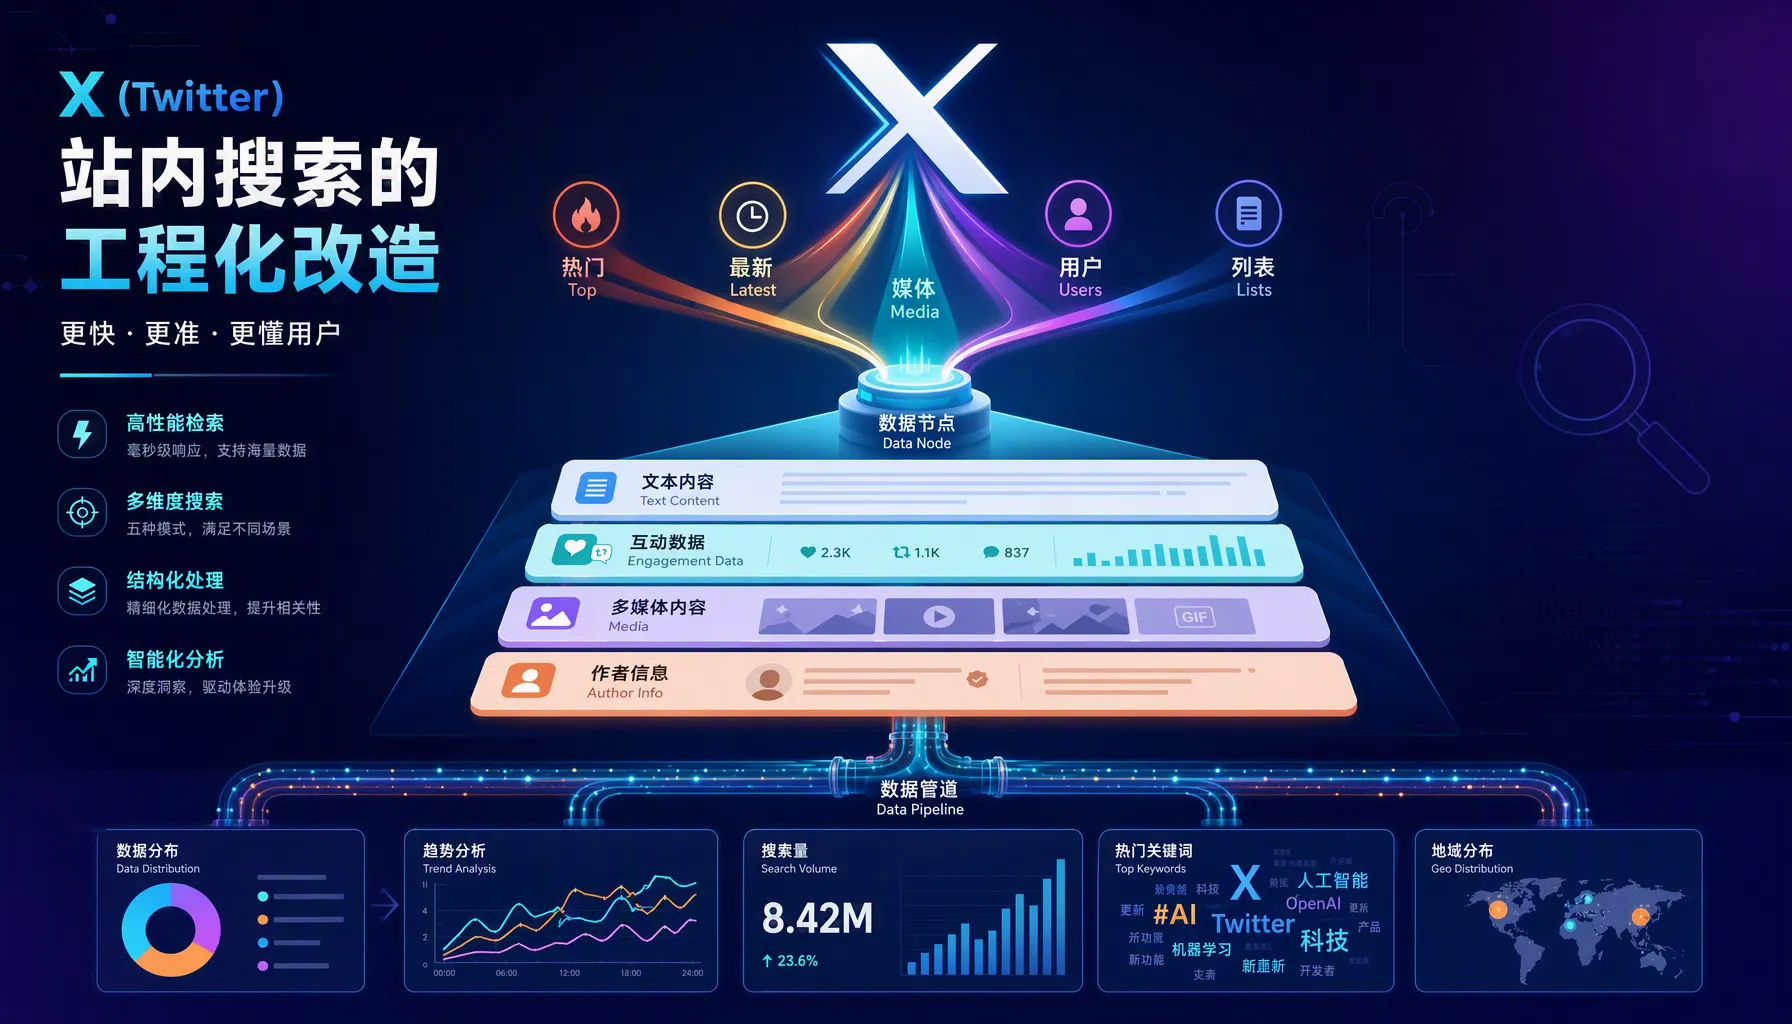
摘要:X(Twitter)站内搜索的排序逻辑不透明、筛选能力弱、结果无法结构化复用,对做舆情分析和竞品调研的运营团队来说效率极低。本文实测红狐 hub 上的「X(Twitter)作品搜索」Skill(twitter-work-search),拆解其核心设计:五种搜索模式的意图映射机制、结构化输出的四层数据模型、智能分页的状态管理,并从意图识别策略、数据建模思路、分页技术选型三个工程维度展开分析。
01 站内搜索的工程瓶颈
用 X 站内搜索找内容,普遍存在三个问题:
- 排序不可控:热门排序的算法不透明,广告和旧内容混在一起,无法按需切换"最新"或"只看媒体"
- 筛选能力弱:想看图片视频要手动拼筛选语法(
filter:images),找账号、找列表更是没有入口 - 结果拿不走:搜索结果是渲染后的页面,不是结构化数据——正文、互动数据、作者信息都得手动复制整理
对个人用户这些可以忍,但对靠 X 做选题、做监控、做调研的团队,这是每天的硬成本。站内搜索的设计目标是"给人看",不是"给程序用"。 数据需求驱动下,需要的是一个把搜索结果结构化输出的方案。
02 核心设计:五种搜索模式与意图映射
红狐 hub 上的「X(Twitter)作品搜索」Skill 把搜索意图收敛为五种模式,每种模式对应一类明确的使用场景:
| searchType | 触发关键词 | 适用场景 |
|---|---|---|
| Top(热门) | 热门、热度、最火、Top | 看"大家都在聊什么",综合热度排序 |
| Latest(最新) | 最新、最近、新发布 | 追实时动态,按发布时间倒序 |
| Media(媒体) | 图片、视频、媒体、照片 | 找带图/带视频的推文,素材采集 |
| People(用户) | 用户、账号、找人、博主 | 搜账号,找领域 KOL |
| Lists(列表) | 列表、Lists | 搜主题聚合列表 |
这个设计的工程价值在于意图映射层:用户不需要记忆 searchType=Media 这样的参数,Skill 从自然语言中提取关键词和搜索类型偏好。比如"找一下巴黎奥运相关的图片和视频"会自动映射为 Media 模式。
从实现视角看,意图映射通常有两种策略:
- 关键词匹配:从用户输入中检测预定义触发词(如"最新"→Latest,"图片"→Media)。实现简单,但表达能力有限——用户没有说出触发词时可能匹配失败
- 分类模型推断:用轻量分类器对用户输入做意图分类,不依赖特定关键词。泛化能力更强,但需要预训练或规则兜底
当前 Skill 更可能采用第一种策略(规则匹配),但通过人类语言的高覆盖触发词库(每条模式提供 3-4 个触发词),已经在实用性和实现复杂度之间取得了平衡。这种把参数化的 API 封装成口语化接口的设计范式,也是所有 Agent Skill 的通用做法。
03 数据结构化:四层数据模型的设计思路
搜索结果的每条推文包含四层字段,这是"能用的数据"和"能看的内容"的分界线:
第一层:推文本体    正文、发布时间
第二层:互动数据    点赞 / 转发 / 回复 / 收藏 / 浏览
第三层:媒体附件    图片封面、视频播放地址(多清晰度)
第四层:作者画像 昵称、粉丝数、认证状态、所在地这个四层模型本质上是为一篇推文做了一次实体关系建模(Entity-Relationship Modeling):
{
  "tweet": {
    "id": "推文ID",
    "text": "正文内容",
    "created_at": "2026-08-27T10:00:00Z",
    "interactions": {
      "like_count": 142,
      "retweet_count": 38,
      "reply_count": 12,
      "quote_count": 5,
      "bookmark_count": 67,
      "view_count": 12800
    },
    "media": [
      {
        "type": "photo",
        "url": "https://pbs.twimg.com/media/xxx.jpg"
      }
    ],
    "author": {
      "screen_name": "username",
      "followers_count": 15200,
      "verified": true,
      "location": "Tokyo, Japan"
    }
  }
}- 互动数据是舆情分析的输入——判断一条内容火不火,不需要点进页面数
- 媒体附件是素材采集的入口——图片封面和视频地址直接可提取,不用二次跳转
- 作者画像是信源评估的依据——粉丝数和认证状态决定了这条内容的权重
四层字段组合起来,一条推文就是一个完整的信息单元,可以直接接进下游分析流程。
04 智能分页:从偏移量到游标的状态管理
搜索结果每次返回最多 20 条,超过一页时自动提示翻页,说"下一页"或"继续"即可加载更多。
分页的技术选型值得展开。常见的分页方案有两种:
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 偏移量分页 | page=2&limit=20 | 实现简单,跳转任意页 | 数据变动时结果偏移,大数据集性能差 |
| 游标分页 | cursor=next_token | 结果稳定,性能恒定 | 不能跳转任意页,实现复杂 |
从"翻页自动沿用上次的 searchType"这一行为可以推断,Skill 采用的是游标分页方案。理由如下:
- 提示"满 20 条才可分页"——说明每页是固定大小的快照,而不是基于偏移量的切片
- 翻页后数据不受"中间有新推文发布"的影响——这是游标分页的天然优势
- 不足 20 条时提示已是最后一页——游标为空时自然终止
边界条件:只有当结果满 20 条时才会出现翻页提示,不足 20 条说明已是最后一页。这个提示逻辑对用户是显性的,不会出现"翻不动"的困惑。
另外,翻页时用户不需要重新声明搜索类型——上下文状态由 Skill 维护,这是 Agent 场景下状态管理的一个常见模式。实现上需要在会话中保留当前 searchType、关键词和游标位置三个参数,构成一个简洁的状态元组 (keyword, searchType, cursor)。
05 上手方式与故障排查
# 对话模式(0 代码)
用户:搜一下 X 上关于"AI"的热门推文
助手:为你找到 20 条关于"AI"的热门推文,按热度排序如下...

用户:继续看下一页
助手:已加载下一页,继续为你展示更多推文...

# 关键词与搜索类型分离设计:不指定模式时默认热门(Top)
配置 REDFOX_API_KEY(在 红狐hub 获取)后即可使用。支持任意语言关键词,非中文关键词同样有效。
故障排查:
- 搜索返回"未找到相关推文"时,尝试更通用的关键词、减少限定词,或更换搜索类型(如从"热门"改为"最新")
- 提示 API Key 无效时,检查密钥是否正确配置且未过期
- 翻页未生效时,确认当前结果集是否满 20 条——不满即最后一页
FAQ
Q1:一次能看多少条推文?
每次返回最多 20 条,结果超过一页时自动提示翻页,支持连续查看。
Q2:搜索类型不指定会怎样?
默认按热门(Top)排序。想看最新动态说"最新",找素材说"图片视频"即可自动切换模式。
Q3:可以搜非中文关键词吗?
可以,支持任意语言的关键词搜索。
Q4:搜索结果包含哪些字段?
每条推文含正文、发布时间、六项互动数据、图片封面与视频地址、作者昵称/粉丝数/认证状态/所在地等完整字段。
结语
站内搜索的设计目标是"给人看",而数据驱动的运营流程需要的是"给程序用"的结构化结果。
这个 Skill 给出的答案可以拆解为三层设计:用五种模式收敛意图(意图映射层),用四层字段承载数据(数据模型层),用智能分页延续会话(状态管理层)——每一层都在解决"搜索结果不可编程利用"这个具体问题。
如果把这三层组合成一条完整的数据管道:"搜索 → 评论分析 → 视频下载",就构成了一个面向 X 平台的运营数据基础设施。对运营团队来说,这意味着 X 平台的内容终于可以进入自己的数据管道:选题、监控、调研,都有据可依。
参考资料
- 红狐 Hub Skills 广场:https://redfox.hk/skills?source=ima
- API Key 获取:https://redfox.hk/settings/api-keys?source=ima