从0到1搭建小红书账号对标系统:拆解“相似账号推荐“工具的匹配逻辑
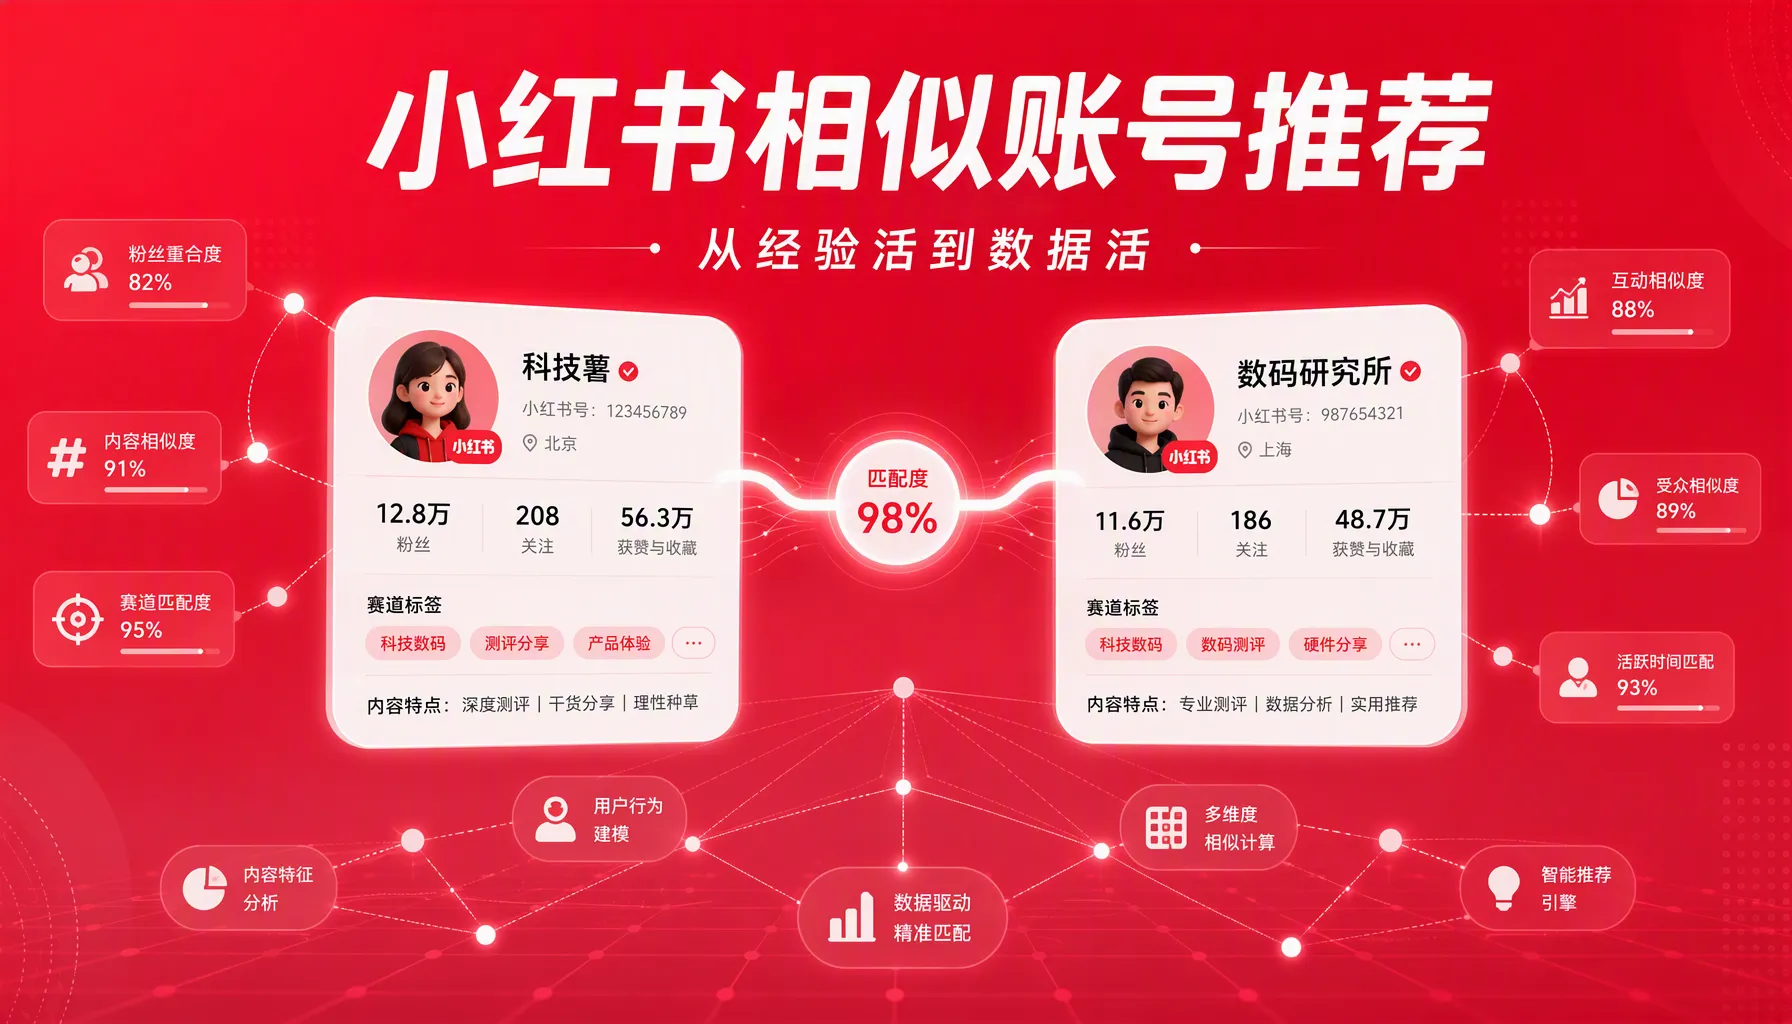
摘要:找对标账号,是小红书运营里最耗时、也最依赖经验的一环。本文以红狐 Hub 上的「小红书相似账号推荐」Skill 为对象,拆解它背后的匹配思路:双模式输入怎么设计、同价对标与高阶标杆两条路径差异在哪、智能模糊映射解决什么问题,以及 API 接入、报告生成、订阅推送这条自动化链路和密钥管理里容易踩的坑。
01 找对标,为什么这么费劲
运营团队做竞品分析时,最常干的活是这样的:从小红书搜索页翻出几十个账号,逐个点进主页,数一数粉丝、翻一翻最近笔记的互动数据,再凭感觉判断"这个号的内容风格跟咱们像不像"。一个账号折腾下来 15 到 20 分钟,一轮分析做完,大半天就没了。
费劲的不只是时间,还有判断标准。
只看粉丝量,选出来的都是头部大号——人家的团队、资源、供应链你复制不了;凭感觉挑,又容易选到"看起来像"但实际赛道、受众完全不同的账号。真正有用的对标,是"跟自己体量接近、数据表现更好、内容还学得动"的账号。这个中间地带,恰恰是人工筛选最盲区的地方。
所以当「小红书相似账号推荐」这类工具出现时,本质上是把"找对标"从经验活变成了数据活。下面按一个技术人的视角,拆一下它是怎么设计的。
02 工具全貌:双模式输入 + 两条推荐路径
「小红书相似账号推荐」(xiaohongshu-similar-account)是红狐 Hub(redfox.hk/skills)上的一个 Skill。它的核心价值一句话能说清:基于粉丝量、赛道、互动数据和内容风格,匹配两类对标账号,并附上 AI 生成的口播化推荐理由和运营分析总结。
先说输入侧。它提供两种查询模式:
| 模式 | 输入内容 | 典型场景 |
|---|---|---|
| ID 直查 | 小红书账号 ID | 已有明确目标账号,想找它的"同类" |
| 组合筛选 | 赛道 + 粉丝数 + 账号等级 | 冷启动或陌生领域,先圈定候选池 |
双模式设计解决的是两个不同的问题。ID 直查适合"以号找号":你认可某个账号的做法,想看看还有谁在用类似的做法。组合筛选适合"以条件找号":你还没想清楚对标谁,但知道自己想要什么体量、什么赛道。
输出侧是两条推荐路径,对应两种运营诉求:
- 同价对标:匹配同类赛道、体量相近的账号,用于学习内容结构和视觉风格;
- 高阶标杆:推荐体量为目标 3–5 倍的潜力账号,用于预判趋势、提前布局。
这两条路径放在一起,回答了运营最常问的一个问题:"我该学谁?"——同价对标告诉你"现在该学谁",高阶标杆告诉你"下一步该学谁"。
除此之外,工具还有三个配套能力:智能映射(关键词或账号不存在时自动做模糊匹配)、HTML 报告生成(结果结构化输出,便于分享存档)、订阅推送(每日 7 点自动更新对标池)。这三项在后面工程部分展开。
03 匹配逻辑拆解:相似账号是怎么"算"出来的
先说清楚:这类工具的具体实现属于各家技术机密,公开信息里不会写算法细节。但"相似账号推荐"在行业内有一套通用做法,从工具的能力描述里可以反推出它的设计思路。
第一步,特征提取。 一个账号在系统眼里是一组特征:粉丝量代表体量,赛道标签代表内容领域,互动数据(点赞、收藏、评论的比例和互动率)代表内容质量,标题句式、笔记类型、更新频率代表内容风格。这些特征大部分来自公开接口,是数据层的输入。
第二步,相似度计算。 把特征放进同一个坐标系,用加权距离衡量两个账号的接近程度。权重怎么配,是这类系统的核心设计——体量差太远学不动,赛道太偏受众窄,互动太低不值得学。一般会按"核心基础 + 运营表现 + 数据特征"分层加权,把不同维度折算到同一个分数上。
第三步,策略分层。 这是"同价对标"和"高阶标杆"的工程本质:同价对标在候选池里限制体量区间,只保留相近量级;高阶标杆则把体量放宽到 3–5 倍,同时提高对增长势头的权重。同一个相似度引擎,换一套过滤条件和权重,输出就是两种完全不同的运营工具。
第四步,模糊映射兜底。 你查的账号不存在、改名或换了领域,怎么办?智能映射用关键词做语义近似——比如查"健身减脂",能关联到"居家塑形""普拉提入门"这类子领域账号。这类实现的一般路径是:分词、同义词扩展、向量化召回,最后按相似度排序补进结果。它解决的是冷启动和脏数据问题:用户输入不可能总是精确命中,系统要能容错。
这套链路并不神秘,但它把"凭感觉挑账号"变成了"按规则筛账号"——规则可复现,结果可追溯,这是它比人工筛选值钱的地方。
04 工程落地:从查询到报告的自动化链路
从工程角度看,这个工具由四个层次组成:
接入层:API + 密钥管理。 数据来自红狐 API,通过 REDFOX_API_KEY 环境变量注入。首次使用需要到红狐 hub注册并获取密钥,之后所有查询走同一套鉴权。用环境变量注入而不是写死在代码里,是接入层最基本、也最容易被忽视的要求。
查询层:双模式解析。 自然语言指令进来后,先解析成结构化查询条件:ID 直查提取账号标识,组合筛选提取赛道、粉丝区间、账号等级,再拼装成 API 请求。这也是"自然语言驱动"类工具的通用结构——前面套一层意图解析,后面还是标准的接口调用。
输出层:HTML 报告生成。 查询结果按固定模板渲染成 HTML 报告,包含推荐账号、匹配理由、指标对比。HTML 的好处是排版可控、浏览器直接打开、方便导出 PDF 或截图走内部评审。对团队协作来说,一份可存档的报告比聊天记录里的文字结果有用得多。
自动化层:订阅推送。 设置订阅后,系统每天 7 点自动更新一次对标池。这一层的通用实现思路是定时任务 + 增量比对:定时拉取最新数据,和上次结果做 diff,只推送变化的部分,避免每天重复轰炸。对运营来说,订阅的意义在于把"定期手动查一遍"变成"每天早上看一份更新"。
05 安全设计:密钥管理这件"小事"不能省
工具页面的密钥说明里有一条值得所有开发者注意:在提供密钥前,先确认密钥来源、可用范围、有效期,以及是否支持重置/撤销,同时禁止在代码、提示词、日志或输出文件中硬编码密钥。
这条规则背后是两个现实风险。
一是密钥泄露等于额度失控。API 密钥按调用计费,一旦泄露,别人可以直接拿你的密钥跑查询。二是密钥要能撤销。环境变量可以随时换,但如果你把密钥写进了代码仓库、写进了提示词,或者让 AI 把密钥打印到了日志里,换一个 key 就要牵连所有引用它的地方。
实际操作上,正确姿势是:密钥只存在于本机环境变量或配置文件,代码里只引用变量名;定期检查密钥有效期;一旦怀疑泄露,立刻去红狐 hub 重置。这跟管理数据库密码是同一套纪律,只是很多人对"AI 工具的密钥"放松了警惕。
06 适用边界:什么场景该用,什么场景别指望
诚实地说,这类工具的边界也很清楚。
它擅长的事: 冷启动阶段快速圈定对标池;竞品监测(配合订阅推送,每天看动态);内容复刻前的结构参考;MCN 批量评估候选账号。
它不擅长的事: 数据是公开接口的实时快照,平台接口一变,数据就有延迟;推荐是基于数据相似性的匹配,账号"数据像"不等于"商业上可复制";报告给的是参考方向,不会替你判断选题能不能爆。
工具解决"找得到、找得准"的问题,"用得好不好"还是运营自己的事。
FAQ:常见问题
Q1: 用这个工具需要写代码吗?
不需要。查询全部通过自然语言完成,密钥配置也只需要设置一次环境变量。把它当成一个会查数据的助手用就行。
Q2: 数据来源可靠吗?
数据来自红狐 API 的公开数据接口,报告会标注数据置信度。要注意数据存在时效性,平台接口调整时,当天数据可能延迟或缺失。
Q3: ID 直查和组合筛选,我应该用哪个?
有明确想对标的账号,用 ID 直查"以号找号";还没有目标、只知道想做哪个赛道,用组合筛选先圈候选池。两条路径可以配合:先用组合筛选定位,再用 ID 直查深挖。
Q4: 订阅推送每天 7 点,推送的是什么?
对标池账号的最新动态和新增的高潜账号。推送是增量式的,只报变化,不会每天重复发一份全量列表。
结语
回到开头的场景:如果现在让你给团队搭一套"找对标"的流程,你会怎么做?
人工筛选的问题不在于慢,在于不可复现——今天凭感觉选的账号,下个月换了人,标准就变了。而把"找对标"拆成特征提取、相似度计算、策略分层、模糊匹配四个环节,每一步都可检验、可调整、可迭代。这大概就是这类工具真正值得借鉴的地方:它没有发明新算法,只是把运营的经验规则工程化了。
下次再有人说"找对标靠经验"的时候,你可以回一句:经验也可以写成规则,规则可以跑成流水线。
参考资料
访问时间:2026 年 8 月,信息来源于红狐 Hub 工具页面与公开技术资料:
- 红狐 Hub Skills 广场:https://redfox.hk/skills?source=csdn
- 相似账号推荐通用技术路径:特征工程与加权匹配(公开资料整理)