别再手动整理知识库,让 Skills 自己进化!
干货分享 · 聚焦 ima(腾讯 AI 知识管家)平台的 Skills 三层结构与实践路径
知识库这件事,很多人还停在"手动整理"的阶段:收藏夹里躺着几千条从未点开的链接,笔记越记越乱,文件传上去就再也不管。真正的问题是,你花在整理上的时间,永远追不上资料的增速。
ima 的 Skills 机制,给出了一条不一样的路:把"整理知识"本身变成可版本化的能力包,让它在真实任务反馈里自己进化。
一、ima Skills 的三层结构
ima 是腾讯推出的 AI 知识管家,以知识库为基础,提供"搜、读、写"一站式体验,网页、PDF、Office、Markdown 等 19 种格式的内容都可以存进知识库。2026 年 3 月,ima 上线了 Skills 功能:一个官方接入包,包含 OpenAPI 和本地技能配置。安装之后,OpenClaw、WorkBuddy、QClaw 这类 Agent 就可以通过 API Key 直接操作你的知识库和笔记——检索资料、导入文档、整理笔记,全程不需要打开 App。
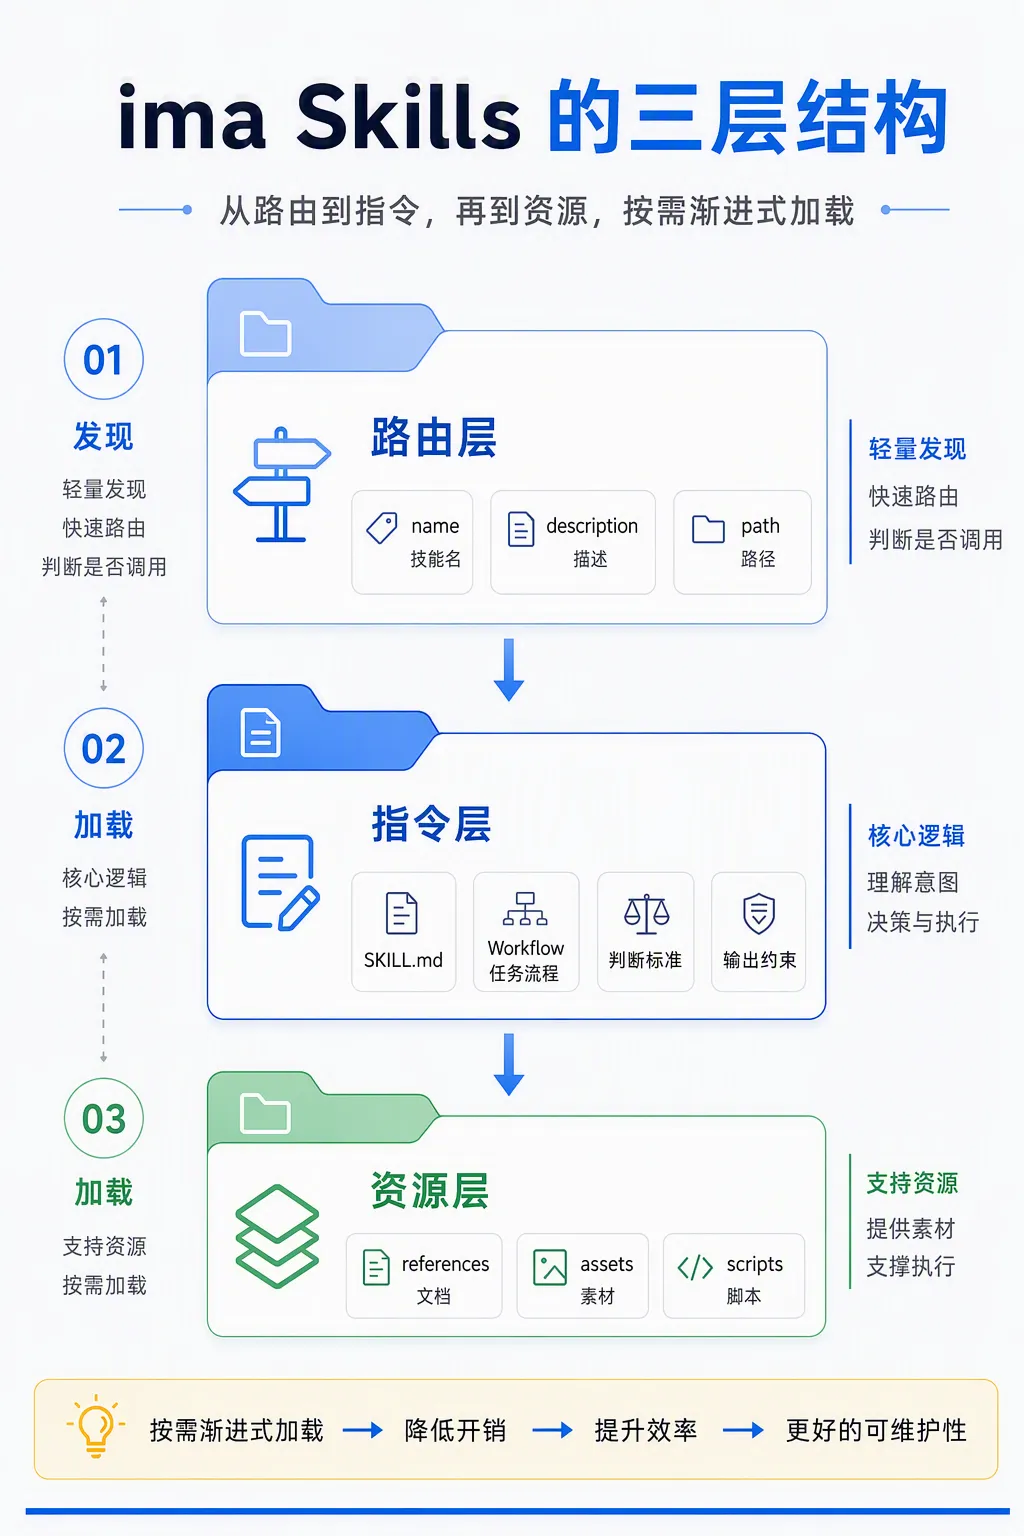
在 Agent 系统里,Skill 可以理解为一种可版本化的能力包。它通常以一个目录存在,核心入口是 SKILL.md,包含元信息和任务指令,也可以配合参考文档、模板、示例和脚本一起使用。按照 Agent Skills 的设计,一个 Skill 大致可以分成三层:
第一层是路由层,包括 name、description 和路径,用来帮助 Agent 判断当前任务是否适合调用这个 Skill。第二层是指令层,也就是 SKILL.md 的正文,用来描述任务流程、判断标准、工具策略和输出约束。第三层是资源层,比如 references/、assets/、scripts/,用于存放更详细的文档、样例、模板或可执行代码。
这套结构对应一种渐进式加载机制。Agent 启动时先看到每个 Skill 的名字、描述和路径;当用户任务匹配某个 Skill 时,再读取完整的 SKILL.md;执行过程中如果需要更细的信息,再继续读取引用文件或运行脚本。这样,一个 Agent 可以同时拥有很多 Skills,同时保持上下文轻量。
装上 ima skills 之后,Agent 能碰的不只是你的知识库。红狐 hub 这类 AI 技能基础设施平台,在 Skills 广场上提供了上百个数据与内容类 Skill,安装后 Agent 就能实时拉取微博评论、公众号爆款、小红书榜单等数据源。这时候 Skill 的「资源层」连接的不再只是文档,而是一条条真实的数据管道——这也是三层结构里最容易被低估的一层。
二、自进化:让三层结构在真实反馈中持续更新
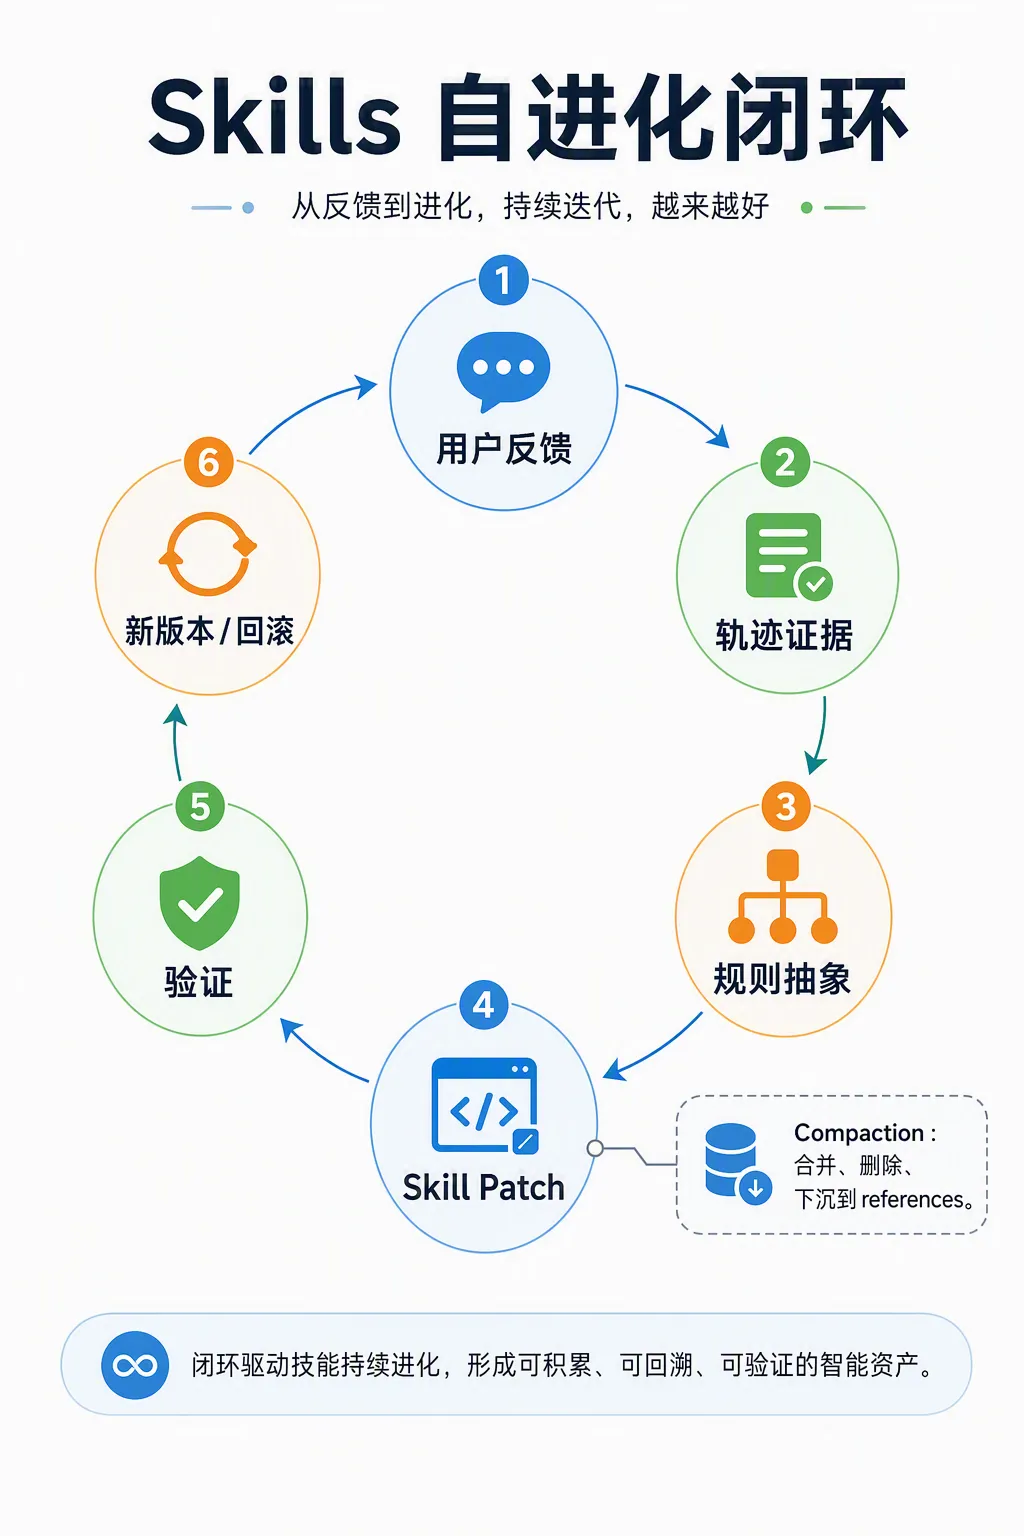
Skills 自进化,核心是让这三层结构在真实任务反馈中持续更新。路由层可以被优化,让 Skill 的触发边界更准确;指令层可以被更新,让任务流程和判断标准更稳定;资源层可以被补充,让 Agent 在复杂场景下有示例、模板或脚本可用。每一次进化都应该能回答三个问题:改了哪一层,解决什么问题,用什么结果证明它更好。
举一个例子:把 ima 知识库接进 Agent 之后,你很可能第一个想做的就是旅行攻略助手。最初的 travel-planner-skill v1.0 可能长这样:
---
name: travel-planner
description: 基于目的地、日期和偏好,规划多日旅行行程。
---
## Workflow
1. 收集目的地、日期、预算和旅行偏好。
2. 搜索景点、餐厅和交通方式(检索 ima 知识库中的攻略资料)。
3. 按天安排景点。
4. 生成逐日行程。
## Output
每天一个章节。包含景点、美食推荐和交通说明。
这个版本可以生成行程。比如用户说:"我想去京都玩三天,喜欢寺庙、咖啡店和轻松一点的节奏。" Agent 可能输出:
Day 1:清水寺、二年坂三年坂、八坂神社、祇园
Day 2:伏见稻荷大社、锦市场、鸭川
Day 3:金阁寺、岚山、竹林小径
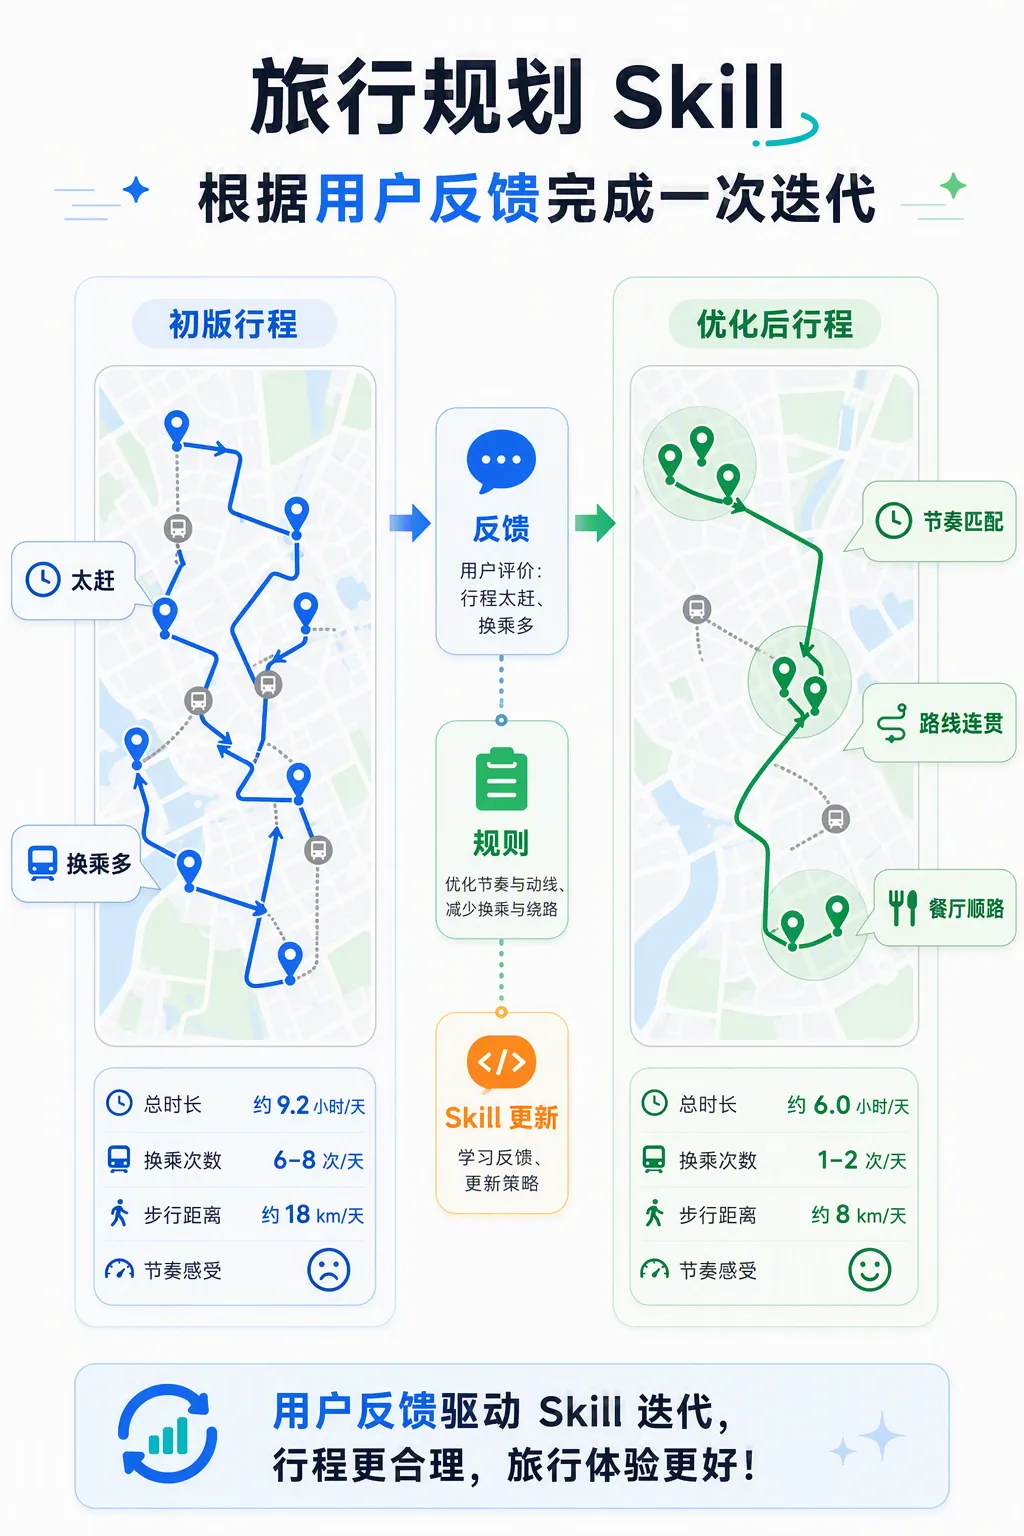
信息看起来完整,但真实旅行体验可能不够好。第三天把金阁寺和岚山放在一起,交通时间偏长;"轻松一点"的偏好也没有真正进入安排。用户继续输入:"第三天太赶了,我不想频繁换乘,餐厅最好顺路一点。"
这些后续 prompt 会先被记录为任务轨迹的一部分,包括用户原始需求、Agent 初版方案、用户修改意见、最终采纳版本和结果评价。优化器会分析这些反馈,把一次性的表达抽象成更稳定的规则。比如"第三天太赶了"可以抽象成:当用户偏好轻松行程时,每天控制 2-3 个主要停靠点,并保留休息时间;"不想频繁换乘"可以抽象成:优先选择同一区域内的景点组合,减少跨区域移动和换乘次数;"餐厅最好顺路"可以抽象成:餐厅和休息点应尽量靠近当天路线。
三、把每一条反馈写到正确的一层
这些规则会进入候选修改。系统会判断它应该写到哪一层:触发边界相关的问题,修改路由层的 description;行程安排相关的问题,修改 SKILL.md 里的 Workflow;质量判断相关的问题,修改 Quality checks;亲子旅行、长辈旅行、预算旅行等细分场景,更适合放进 references/,让 Agent 在需要时按需读取。
改指令层:从"景点罗列"到"按区域和节奏组织"
第一次迭代可以先改 Workflow。原来是:
2. 搜索景点、餐厅和交通方式(检索 ima 知识库中的攻略资料)。
3. 按天安排景点。
候选修改变成:
2. 搜索景点、餐厅和交通方式(检索 ima 知识库中的攻略资料)。
3. 在分配进每天之前,先按地理区域对候选地点做聚类。
4. 估算主要停靠点之间的交通时间。
5. 按用户的节奏偏好匹配每天的密度:
    - 轻松:每天 2-3 个主要停靠点,保留缓冲时间
    - 标准:每天 3-4 个主要停靠点
    - 紧凑:每天 4-6 个主要停靠点
这次改动落在指令层的任务流程。它让 Agent 在安排行程前先做区域聚类,再估算主要地点之间的交通时间,最后根据用户偏好控制每天的密度。旅行计划会从"景点罗列"变成"按区域和节奏组织"。
加判断标准:新增 Quality checks
接着可以改判断标准,新增一段:
## Quality checks
在确定行程之前,检查:
- 每天是否基本停留在同一个地理区域内。
- 主要停靠点之间的交通时间是否合理。
- 主要停靠点的数量是否匹配用户的节奏偏好。
- 餐厅和休息点是否安排在路线附近。
这一步解决的是行程质量校验。Agent 生成结果前,需要自查路线是否顺、交通是否合理、餐厅和休息点是否贴近当天路线。对旅行计划来说,这类判断标准比单纯增加景点更重要。
下沉资源层:细分场景按需读取
如果后续发现用户经常提到"带老人小孩,少走路",这类需求可以进入资源层。比如新增:
references/family-travel-constraints.md里面写亲子或长辈出行的约束,例如减少换乘、控制步行距离、安排午休、优先选择交通便利的景点。主 SKILL.md 只保留一句触发说明:
如果用户提到儿童、长辈、婴儿车或行动不便,在确定行程前先读取
references/family-travel-constraints.md。
这样,主 Skill 保持轻量,细分场景放到资源层按需读取。Agent 只有在用户提到相关偏好时,才加载更细的参考内容。
定期做 Skill compaction:压缩与重构
随着迭代次数增加,Skill 会逐渐更详细。好的自进化系统还需要定期做 Skill compaction,也就是压缩和重构。它会检查哪些规则重复,哪些规则长期没有触发,哪些细节应该从主文件下沉到 references,哪些规则可以合并成更高层的原则。
比如主文件里原本堆了很多规则:
- 不要把距离很远的景点放在同一天
- 每天要控制景点数量
- 轻松旅行要留休息时间
- 餐厅要靠近当天路线
- 亲子旅行要减少换乘
经过压缩后,可以合并成一条更稳定的质量标准:
优先保证路线连贯与节奏匹配:每天在地理上保持连贯,按节奏限制主要停靠点数量,
餐厅和休息点靠近路线,亲子行程减少换乘。
用验证决定新版本能否发布
候选 Skill 生成后,需要进入验证环节。系统可以拿一批历史旅行规划任务,让 v1.0 和 v1.1 分别生成行程,再比较几个指标:每天跨区域移动次数是否下降,平均交通时间是否减少,用户偏好是否被显式满足,行程密度是否符合预期。如果新版本表现更好,就发布为 travel-planner-skill v1.1;如果它过度保守,导致行程内容太少,这次修改会被拒绝,并记录为下一轮优化的负反馈。
红狐案例:一个连上真实数据的 Skill 长什么样
前面用旅行助手演示了进化的过程,红狐 hub 上的「微博评论分析」Skill则是一个可以直接观察的成品样本。
它的工作一句话讲完:丢一条微博链接进去,它把这条博文下的评论拉出来——谁评论的、说了什么、被赞多少次、什么时候发的,一目了然。点评论人昵称,直接跳进 TA 的微博主页。
把它套进三层结构里看:
- 路由层:name 加 description,告诉 Agent「什么时候该调它」——用户丢来微博链接、想了解评论区时触发;
- 指令层:SKILL.md 里规定任务流程——解析链接、查询评论、按时间或热度排序、输出带时间戳的评论列表;
- 资源层:真正拉开差距的地方。它不是文档,而是一条数据管道:每次查询实时拉取平台刚更新的数据,不用旧缓存糊弄你。累计 1 万多次调用,每一次靠的都是管道,不是措辞。
它身上还能看到自进化的痕迹:做舆情的人最怕过期存档,于是「数据新鲜」成了硬约束,每条评论都带时间戳;海量评论支持翻页,一句「下一页」继续看,因为真正有价值的评论往往不在前 20 条——这些都不是一次性 prompt 能留下的东西,而是反馈积累成规则、规则写进 Skill 后的结果。
这个案例说明:三层结构里,路由层和指令层决定一个 Skill 好不好用,资源层决定它能不能长期被用。1 万多次调用,是用户用脚投出来的票。
小结:从手动整理知识库到持续运营 Skills
这个例子说明,Skills 自进化关注的是可定位、可验证的小步更新。用户反馈先成为证据,证据被抽象成规则,规则被写入合适的 Skill 层级,再通过验证决定是否进入新版本。随着规则积累,系统再通过压缩、合并、下沉和删除,让 Skill 保持清晰、轻量和可维护。
长期来看,你的知识库使用方式会逐渐从单次手动整理,走向持续运营 Skills。模型提供通用推理能力,ima 知识库提供资料底座,红狐这类平台提供数据管道,Skills 承载可复用的程序性知识。真实任务中的反馈不断进入 Skill 的路由层、指令层和资源层,最终形成一套可版本管理、可评估、可回滚、可复用的能力体系。
下次打开 ima,与其继续把新资料丢进收藏夹,不如先想想:它该进路由层、指令层,还是资源层?
资料来源
- 「微博评论分析」Skill 官方页面:https://redfox.hk/skills/no/hD2X5aT9?source=ima
- 红狐 hub Skills 广场:https://redfox.hk/skills?source=ima