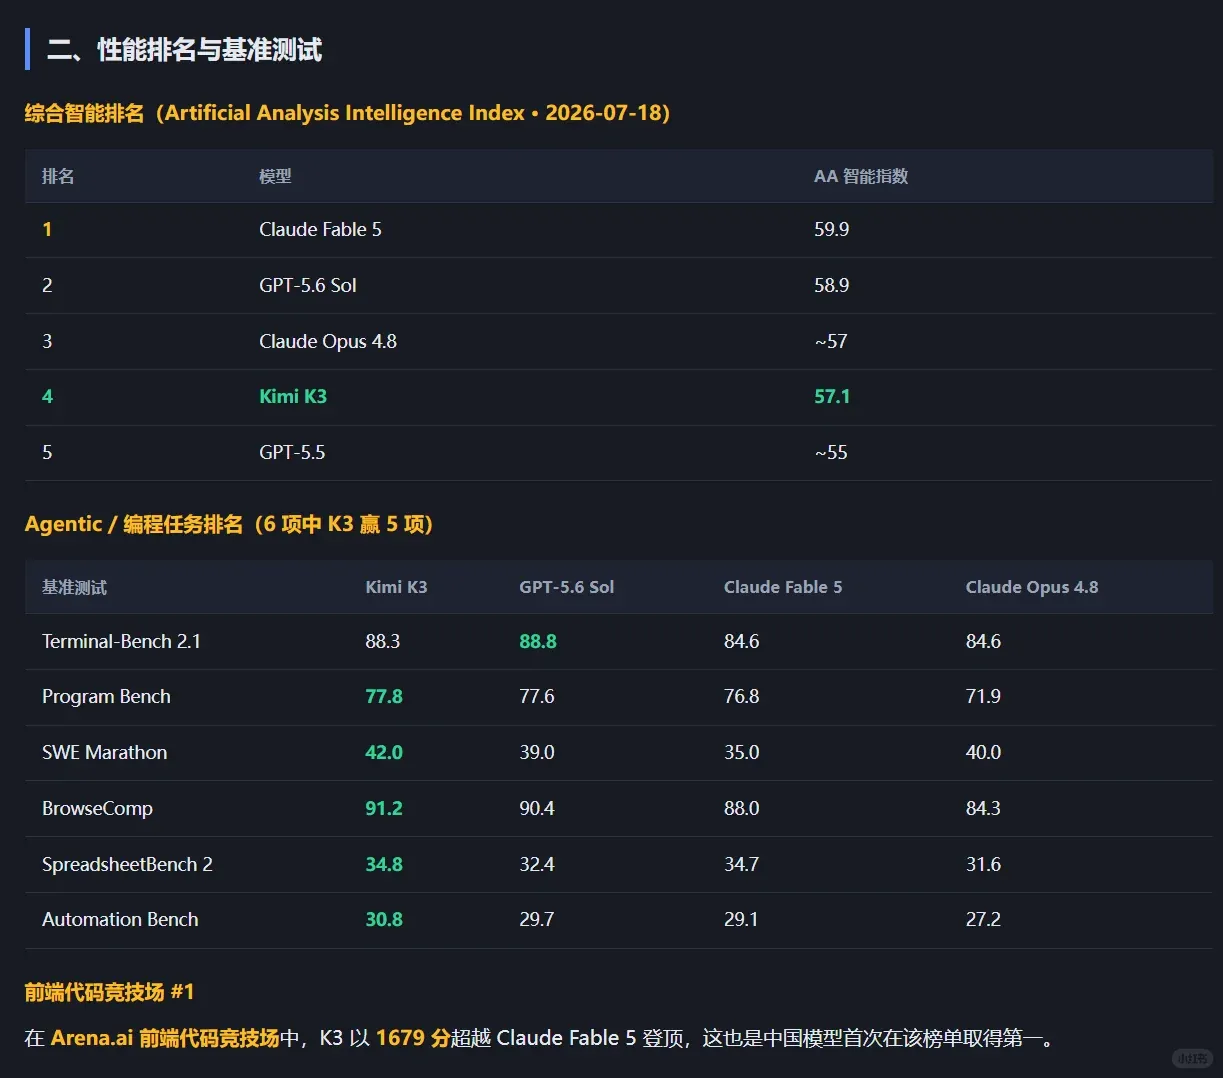
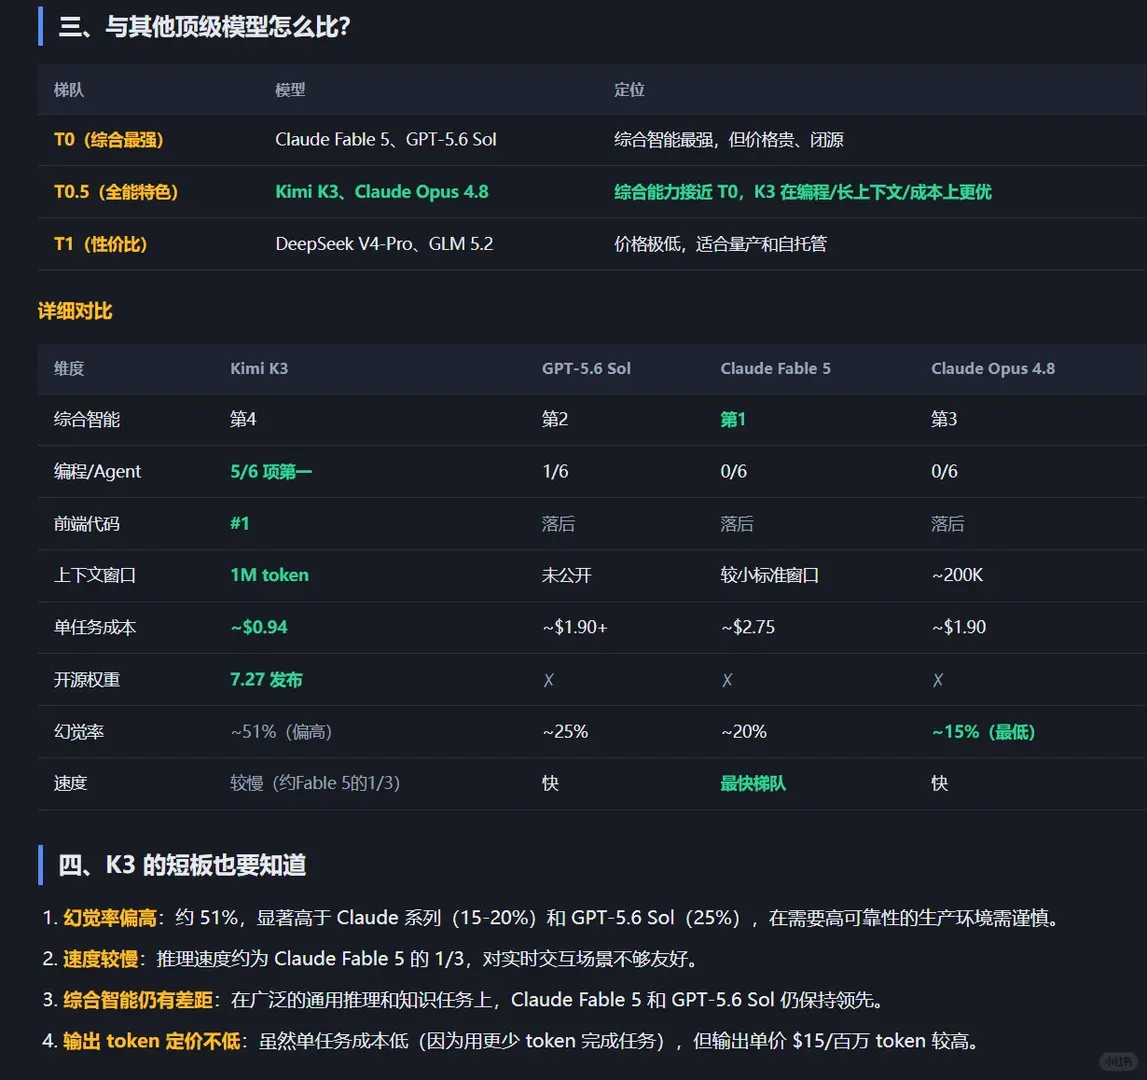
kimi反而提到了更多k3的限制和缺点!
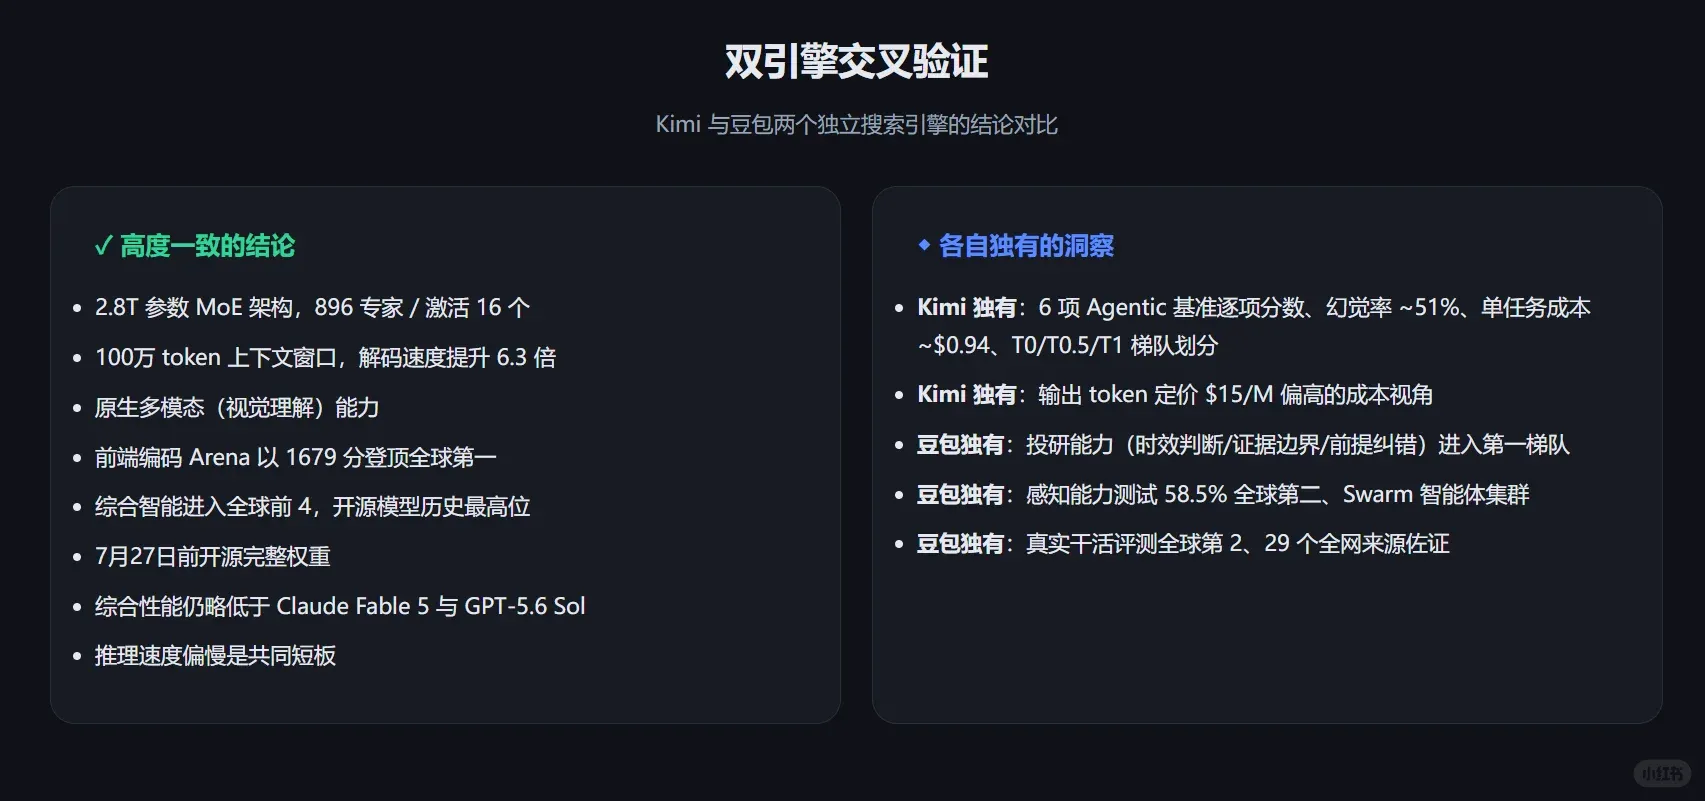
高度一致的结论
——2.8T 参数 MoE 架构,896 专家 / 激活 16 个
——100万 token 上下文窗口,解码速度提升 6.3 倍
——原生多模态(视觉理解)能力
——前端编码 Arena 以 1679 分登顶全球第一
——综合智能进入全球前 4,开源模型历史最高位
——综合性能仍略低于 Claude Fable 5 与 GPT-5.6 Sol
——推理速度偏慢是共同短板
◆ 各自独有的洞察
——Kimi 独有:6 项 Agentic 基准逐项分数、幻觉率 ~51%、单任务成本 ~$0.94、T0/T0.5/T1 梯队划分
——Kimi 独有:输出 token 定价 $15/M 偏高的成本视角
——豆包独有:投研能力(时效判断/证据边界/前提纠错)进入第一梯队
——豆包独有:感知能力测试 58.5% 全球第二、Swarm 智能体集群
——豆包独有:真实干活评测全球第 2
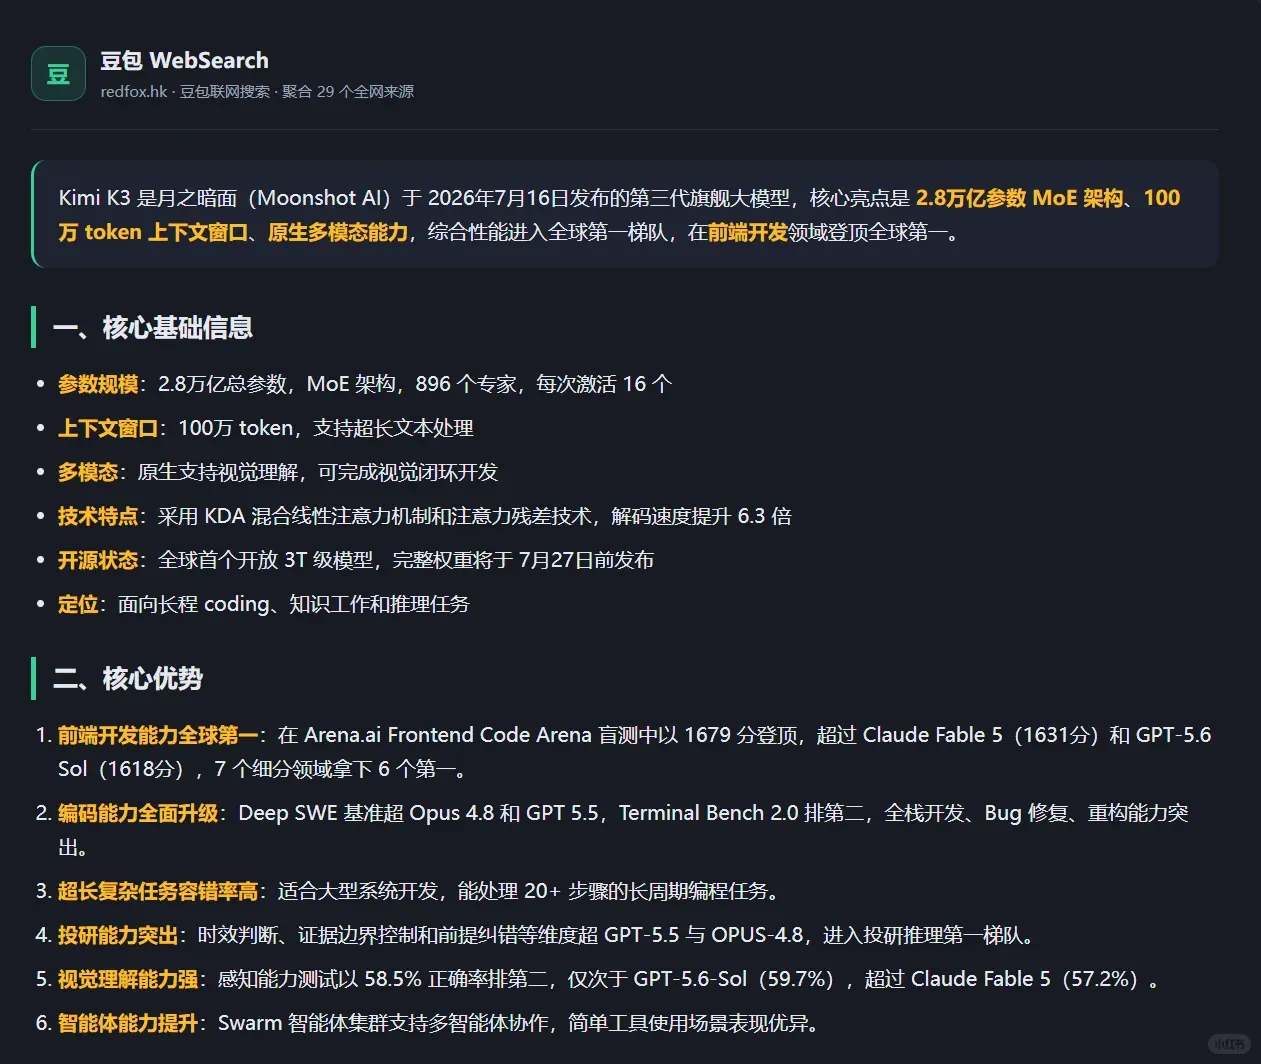
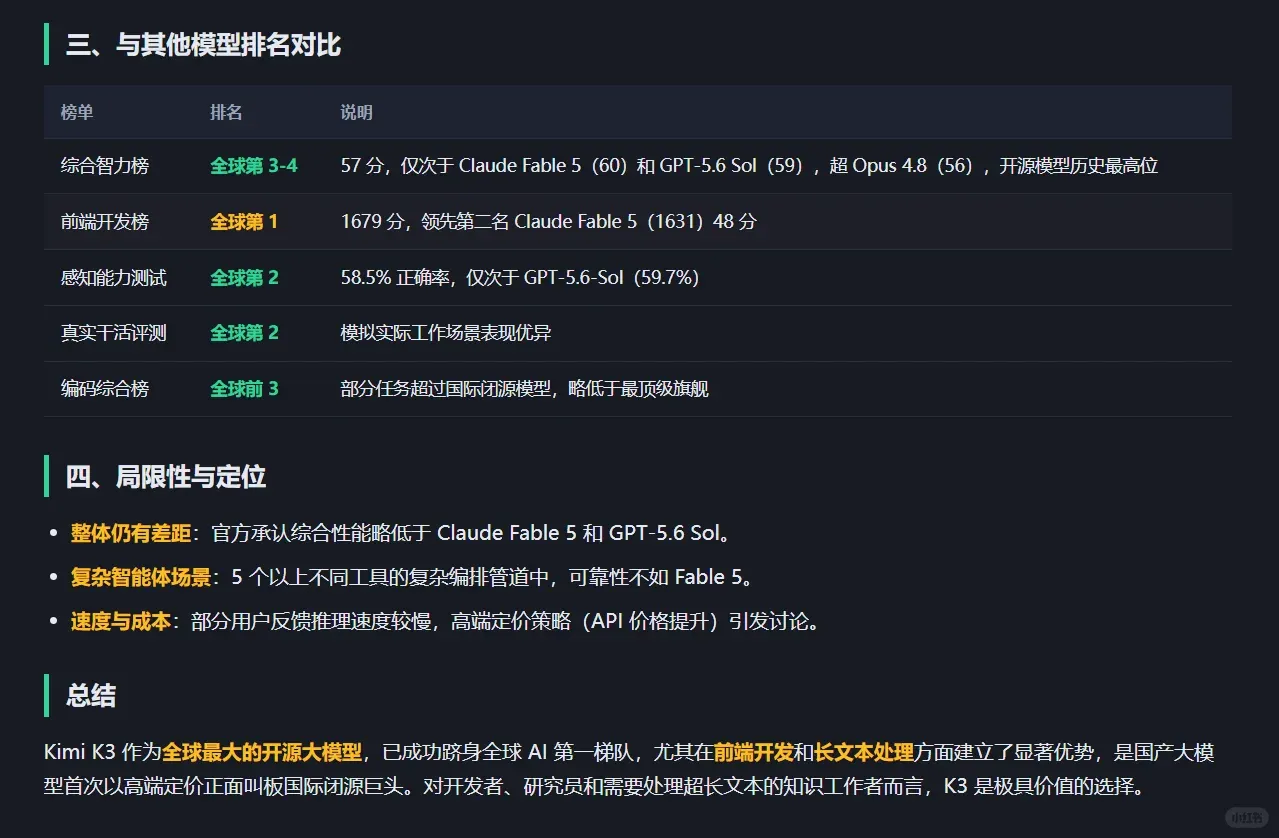
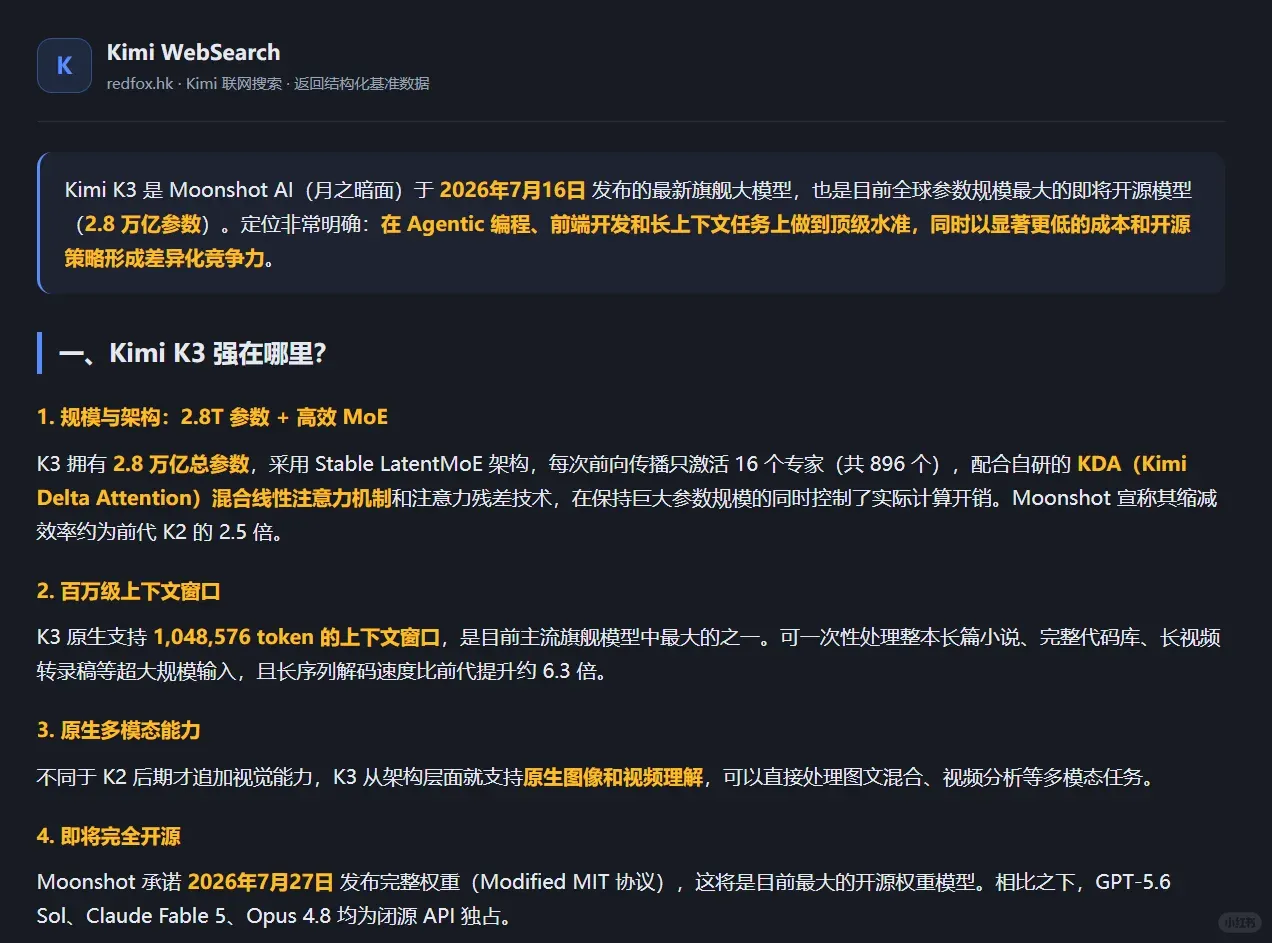
以下为具体的豆包和kimi报告解答: